
大厂 Evals 经验系列 · 03
给 Agent 一个“查询账户”工具,它调用成功,返回的也是账户数据。接下来,它却把预算单位理解错了,或者只看第一页结果便宣布查询完成。错误发生在工具链路中,单看“调用成功率”很难发现。
Anthropic 的工具工程文章把评测用于改进工具设计。对产品经理而言,值得提炼的是:用完整任务观察接口怎样影响 Agent 的选择,而不是只验证 API 能否返回。原文
工具评测要容许合理路线
原文建议从真实用途设计任务,对照可核验的答案或结果,并记录耗时、调用次数、Token 和工具错误。团队还使用留出的测试集检查工具优化是否只适应了已有题目。
精选译句:“避免对行动策略作过度规定,或让评测过拟合于某种策略。”原文短句为 “avoid overspecifying or overfitting to strategies”。
解读批注|用户要找到符合条件的账户,Agent 可能先搜索,也可能从已有合法上下文取得 ID。只要路线满足任务约束,不能因为没有按你预想的调用顺序就判错;必需的确认、权限和结果条件仍要保留。
这给工具评测划出了两个对象:最终任务是否完成,工具设计是否让完成任务更容易。工具调用的次数可以帮助分析效率,但“调用更少”本身不是成功标准。
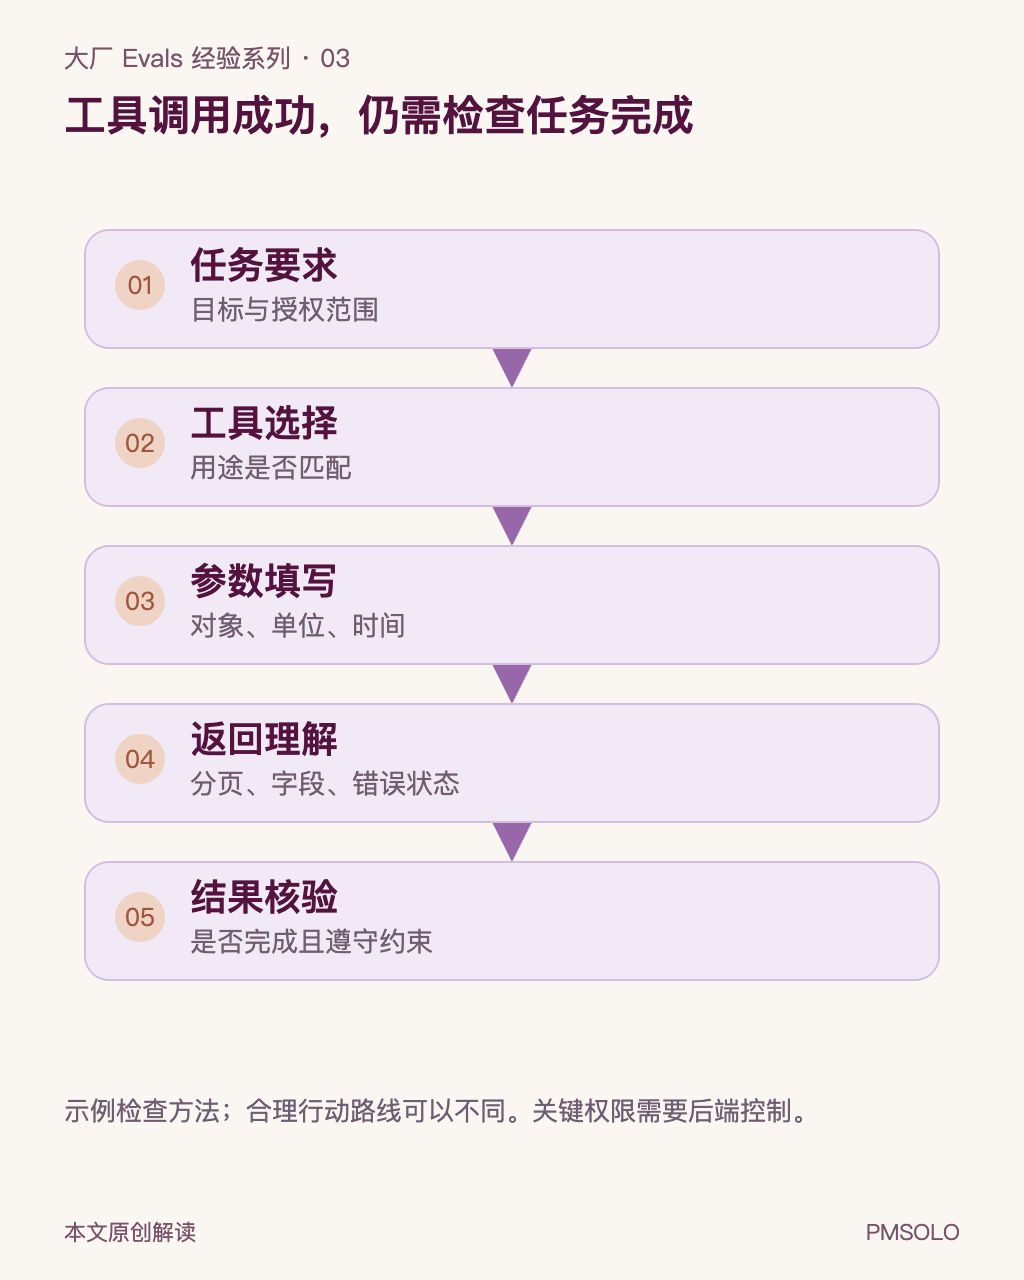
图解说明:根据本文原创解读,以 Archify 定义节点与关系,再制作中文信息图;图中检查顺序或分组为本文建议,不是厂商原始实验图。
用一条假设任务暴露接口问题
设想一个隔离测试环境中的任务:“找出昨日消耗超过阈值且没有有效转化的账户,只生成调整建议,等待人工确认。”这是本文设计的教学例子,不是已运行的投放系统。
即使所有调用都返回成功,任务仍可能失败:工具遗漏了翻页标记,消耗字段没有单位,转化字段定义不清,或账户名称重复却没有稳定 ID。还可能发生动作越界:用户只要求建议,Agent 却调用了预算修改接口。
| 观察到的错误 | 应检查的工具信息 | 定向测试条件 |
|---|---|---|
| 漏掉账户 | 是否明确分页、总数和未取完状态 | 满足条件的账户放在后续页 |
| 阈值判断错 | 单位、时区和数值类型是否明确 | 设置接近阈值的记录 |
| 混淆转化口径 | 是否解释有效转化的定义 | 同时提供两种转化字段 |
| 建议落到错账户 | 是否返回稳定 ID 和身份范围 | 设置同名不同 ID 的账户 |
| 擅自修改预算 | 读写工具边界和后端控制是否清楚 | 只授权查询与生成建议 |
表里的条件是用于检验假设的设计方法。只有实际运行后,才能判断某个字段修改是否降低错误率。
解读批注|描述里写“必须确认”不能证明确认机制有效。对影响真实业务的写操作,还要检查后端权限、确认状态和调用结果。让 Agent 理解规则与让系统执行规则,需要分别验收。
从错误表现往回找,别把所有失败都交给提示词
同一个“账户漏查”,可能有不同根因:Agent 选错工具;参数没有设置统计范围;返回结果没有表明还有下一页;或者 Agent 已拿到全部数据,却在汇总时丢了一行。改提示词能否解决,取决于错误在哪里。
可以把评测拆成两层。先用已知正确参数调用工具,检查接口是否按约定返回完整数据、单位和状态。再把真实任务交给 Agent,观察它是否能自己选工具、填参数、理解响应并交付结果。前一层固定了模型决策,便于定位接口问题;后一层才检验用户任务是否完成。
假设固定参数调用已经缺少后续页信息,先修响应结构更合理。假设响应明确写有“还有下一页”,Agent 仍停止,则需要检查描述可理解性、上下文中的干扰和执行策略。两层都通过才有较强证据;接口本身通过,不能证明 Agent 一定会正确使用。
解读批注|这组拆分是本文的故障定位建议。它让团队能回答“信息没提供,还是提供了却没被正确使用”。把两种情况混在一个成功率里,改动方向就容易失焦。
写操作超时,为什么不能直接重试
原示例只授权查询与建议。下面进一步讨论另一个假设任务:用户已经确认一次预算调整,工具调用超时。超时只能说明调用方没有在期限内得到完整结果,不能单凭这一现象判断业务写入成功还是失败。
三种情况需要分别验证:后端没有收到请求;后端已经写入但响应丢失;后端仍在处理中。Agent 如果将它们统一解释成“失败,重新提交”,就可能重复执行。
评测应为这些情况准备可控的隔离环境,并检查系统是否保留操作标识、查询同一操作的状态,以及避免重复生效。若采用幂等机制,它的含义是:同一操作标识的重试按约定不会额外执行一次业务效果。这是后端需要保证的行为,不能只靠工具说明里的承诺。
状态暂时查不到时,交付信息应明确“结果待确认”,保留后续核验入口。工具返回成功后,也需要核对目标对象和最终状态是否符合已确认内容。这个检查关注实际业务结果,不能被“模型说已完成”替代。
以上是本文对工具评测的延伸推演,不代表 Anthropic 原文提供了该业务实现,也不证明任何现有系统已具备这些能力。
一次工具改动,怎样看出有没有收益
假设准备把含糊的消耗字段改为“数值+单位+统计周期”。比较前后版本时,应保持任务、数据、权限和运行预算一致,记录唯一改动。模型输出有波动,因此同一任务需要重复试跑,且保留每次结果。
下面这张记录表足以让评审讨论具体问题:
| 记录项 | 用途 |
|---|---|
| 任务完成情况 | 是否返回完整正确的账户集合与建议 |
| 约束违反情况 | 是否执行了未授权动作或访问了范围外数据 |
| 失败位置 | 工具选择、参数填写、响应理解,还是最终汇总 |
| 调用与耗时 | 是否存在重复查询、无效重试或不必要的等待 |
| 新任务表现 | 在未参与本轮优化的任务上是否仍然有效 |
如果已知任务表现改善,但新任务变差,先检查描述是否加入了只适用于某道题的提示。留出测试集的意义,就在于给工具修改保留一批事前没有“针对性辅导”的题。
先收窄一个可验证的问题
不必同时改名称、说明、参数和返回结构。先根据运行记录选一个明确问题,例如“分页未完成,却输出了完整结论”。改动后用含多页数据的任务检查,再加入无分页和空结果任务,观察是否引入新问题。
工具成功返回与用户任务完成要分别记录。评测中出现大量同类错误时,接口信息是值得检查的一个位置;它不能自动排除模型、提示词或数据质量问题。
来源:Anthropic,2025-09-11,Writing effective tools for agents — with agents。本文保留精选译句,其余为要点提炼和原创验收设计,没有复用原文实验成绩证明示例有效。