
大厂 Evals 经验系列 · 02
AI 查数最容易让人放心的时刻,是它给出了一张整齐的表,又解释了变化原因。表格里有日期、有环比、有结论,检查 SQL 也能正常执行。但这些都不能回答一个问题:它算的是你要的那个指标吗?
这篇从 OpenAI 内部数据 Agent 的工程文章提炼评测方法,再用一个假设的运营查询拆解验收条件。场景和检查表是本文设计的示例,不是 OpenAI 的实际业务数据。
OpenAI 怎样判断查询是否正确
OpenAI 为重要指标和分析模式整理问题集,由人工编写参考 SQL。评测时执行 Agent 生成的查询,将结果与参考查询的结果对照;同时考虑 SQL 和数据,容许不影响答案的合理差异。这是其内部实践的描述,不能据此推定任意数据 Agent 已具备相同能力。原文
精选译句:“生成的 SQL 在语法上可以不同,同时仍然是正确的。”原句为 “Generated SQL can differ syntactically while still being correct”。
解读批注|SQL 文本相同不是唯一验收条件。表连接顺序、别名或等价写法可以变化。更应核验的是指标定义、数据范围与返回结果;但在某一批数据上碰巧算出同样的数,也不足以证明查询逻辑一直正确。
因此,参考 SQL 是一份需要维护的标准答案。数据表、业务口径或权限变了,参考答案也要复查。把旧答案自动当成正确答案,会把业务变化误判为 Agent 退步。
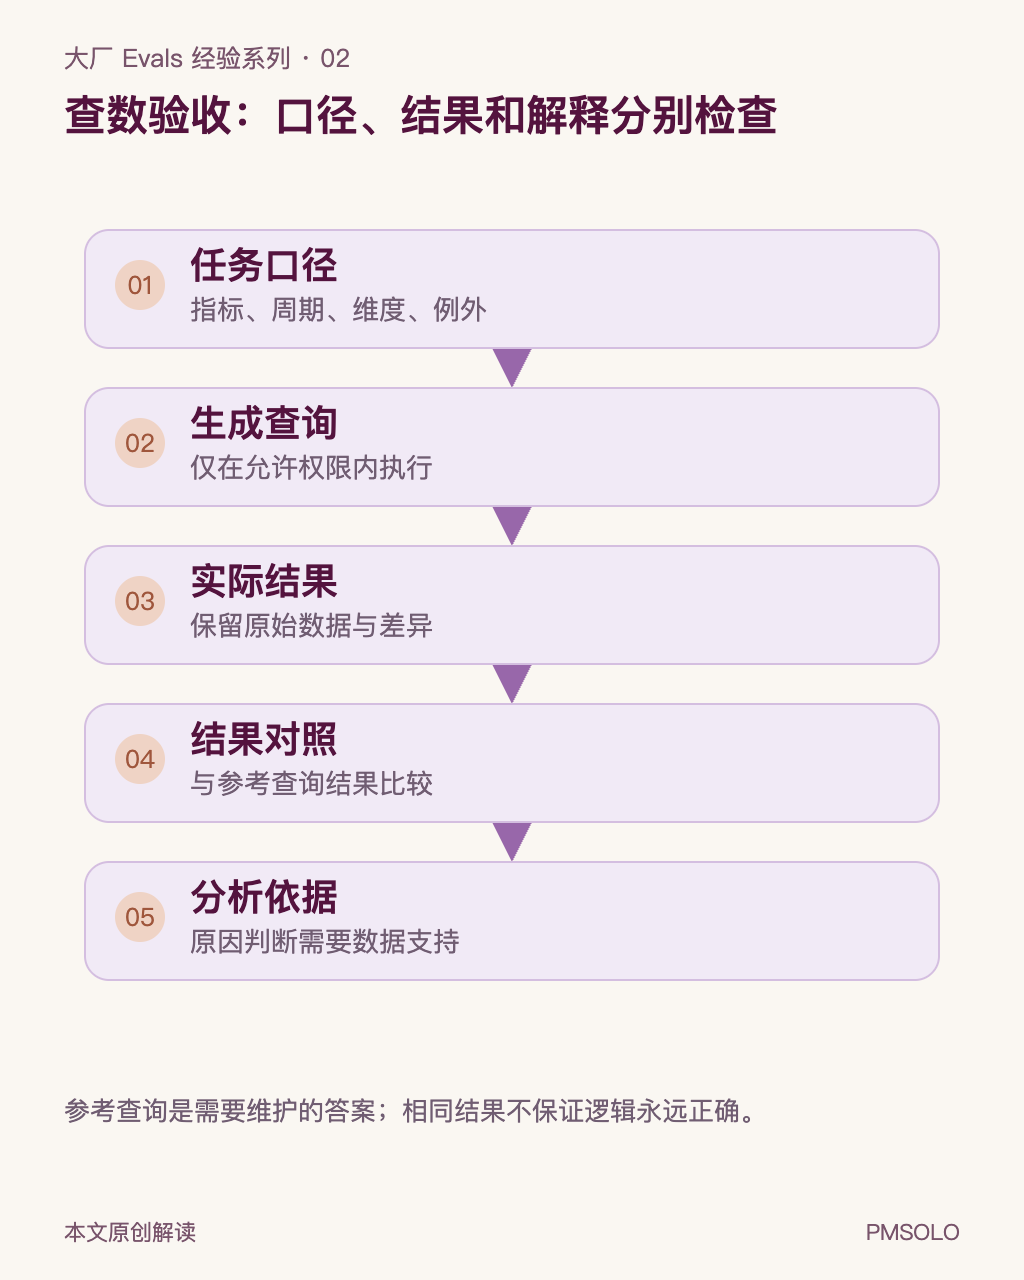
图解说明:根据本文原创解读,以 Archify 定义节点与关系,再制作中文信息图;图中检查顺序或分组为本文建议,不是厂商原始实验图。
一个查询,至少藏着四种口径
假设用户问:“上周哪个账户的转化成本最高?”
这句话至少还缺四个定义:上周是自然周还是最近七天;转化是哪种事件;按哪个时区切分日期;零转化账户如何处理。如果这些定义已经存在于团队标准中,系统应该使用标准并说明依据。存在多种合理口径时,则需要澄清,或显式给出暂用假设。
下面设定一个教学样例:统计范围为上一自然周,指标为消耗除以有效转化数,账户按 ID 合并,零转化账户单独列出。样例不包含真实经营数据。
| 账户 | 两条记录的消耗 | 两条记录的有效转化数 | 应有结果 |
|---|---|---|---|
| 甲 | 100、300 | 1、9 | 总消耗 400,总转化 10,成本 40 |
| 乙 | 200、200 | 2、2 | 总消耗 400,总转化 4,成本 100 |
| 丙 | 150、50 | 0、0 | 单独列为零转化,不能把成本算成 0 |
这些数值使用同一消耗单位。甲账户如果先算每条记录的成本,再取平均,会得到约 66.67,而不是 40。这个差异足以构成一道测试题:检查 Agent 是否按确认的指标定义聚合。
解读批注|上例采用“总消耗/总转化”的业务定义。如果实际需求是逐日成本均值,参考结果就应改变。评测前先确认定义,才能判断算法是错了,还是双方理解不同。
为什么一次结果一致,还不能证明查询逻辑正确
把参考查询与生成查询放在同一份数据上执行,是必要的结果检查,但只能确认这份数据上的表现。错误算法与正确算法可能恰好得到同一个数。
看一个本文设计的反例:两条记录分别为“消耗 100、转化 2”和“消耗 200、转化 4”。总消耗除以总转化为 50;先算每行成本再平均,也是 50。只用这组数据,两种算法无法区分。前面甲账户的 1 次与 9 次转化,才让错误算法暴露出来。
这不是要求堆积更多随机数据,而是围绕口径构造能区分实现的样本。例如:
- 在同一业务统计范围内,将“消耗 300、转化 9”拆成三条“消耗 100、转化 3”。总量成本应保持不变;若改变,需检查聚合是否依赖行数。
- 加入范围外日期的记录。按已确认周期查询时,原结果应不受影响。
- 加入同名但不同 ID 的账户。原账户总量应保持不变,新账户应单独统计。
这些是按业务定义设计的检验关系,不是所有指标都必须满足的数学规律。比如需求如果按天取均值,拆分记录时还要保留日期粒度;随意拆数据就会改变题目本身。
解读批注|测试样本的价值在于排除哪一种错误解释。先问“错误写法会不会也通过这道题”,再决定补什么数据,通常比只增加题目数量更能提升诊断能力。
对照结果之前,先约定“相同”是什么意思
一个结果表可能只是排序不同,也可能真的漏了账户。一个数值可能只是展示时四舍五入,也可能计算口径已经改变。判分规则要把合理差异与实质错误分开。
对没有排序要求的账户集合,可以按稳定 ID 对齐后检查是否缺行、多行或值不同;若任务要求“成本最高的三个账户”,排序、数量和并列处理就属于要求。空值、零值、没有记录也不能自动互换:它们可能分别表示未知、真实为零和没有匹配数据。
数值容差同样要有业务依据。若计算精度允许差异,可以预先定义容差;若规则判断消耗是否超过某个阈值,显示成相同的两位小数仍可能隐藏阈值两侧的差异。这些对齐规则是本文提出的验收设计,不是 OpenAI 原文已实现的统一配置。
最后,生成查询和参考查询必须读取可比较的数据。两次查询之间订单又更新了,结果不同不能直接归因于模型。固定快照、记录执行时间和参考口径版本,是为了让差异有解释,而不只是让测试容易通过。
将“查数正确”写成可以执行的验收条件
我建议把数据 Agent 的验收拆到下面几项。这是从工程实践延伸出的产品检查表,不是厂商统一标准。
| 检查对象 | 具体检查 | 失败时保留什么证据 |
|---|---|---|
| 问题理解 | 是否明确指标、周期、维度和例外规则 | 用户问题、采用的定义及澄清记录 |
| 查询逻辑 | 表、连接、过滤、去重和聚合是否符合定义 | 查询文本、表版本与关键条件 |
| 返回数据 | 在固定数据快照上是否得到参考结果 | 原始结果、预期结果和差异行 |
| 权限 | 是否只返回当前身份允许访问的数据 | 测试身份、允许范围和实际访问记录 |
| 分析结论 | 文字描述能否由查询结果支持 | 结论句和对应数据证据 |
在上面的样例里,乙是有有效转化账户中成本最高的账户。丙需要单列说明。把“丙成本为零,所以表现最好”判为失败,有明确的口径依据。
还可以给同一个逻辑准备第二组数据:新增同名不同 ID 的账户,加入重复记录,再调整一条转化数。原查询如果依赖账户名称合并,或被连接操作重复放大,就会暴露问题。这类小样本能定向检查规则;它不能替代真实业务分布上的覆盖测试。
查数对了,原因分析还要再验一次
假设系统准确算出乙账户成本高,随后写道:“因为素材质量差。”查询只证明了成本大小,没有证明原因。即使这段解释听起来合理,也需要更多证据,例如素材维度、投放人群或同期策略变化。
对此可以增加一个独立检查:要求每个原因判断指向支持它的数据;依据不足时,使用“待验证假设”,并提出下一步查询。查询准确率和分析依据分别记录,才能知道问题发生在计算还是解释阶段。
查询能运行只证明数据库接受了语句。验收还要确认业务口径与结果一致。下一次整理真实查询任务时,先挑一个经常出现分歧的指标,把定义、固定数据和预期结果写在同一条测试记录里。
来源:OpenAI,2026-01-29,Inside OpenAI’s in-house data agent。本篇为精选译句与原创解读,未声称全文翻译,也未验证任何线上产品的当前能力。