
如果一个机器人能把问题回答得头头是道,却不能让事情往前走,它算数字员工吗?
我倾向于不算。
比如用户问:“任务为什么一直卡在 80%?”
机器人马上回复:可能是数据量比较大,也可能是系统繁忙,建议稍后再试。
回答没什么毛病,甚至还挺礼貌。但用户真正想知道的是:到底是哪一步卡住了,现在有没有人在处理,我还要等多久。
这些问题,机器人一个都没解决。
这也是不少数字员工项目尴尬的地方:演示时能聊,上线后还是要人接着干。最后多了一个聊天入口,原来的工作一点没少。
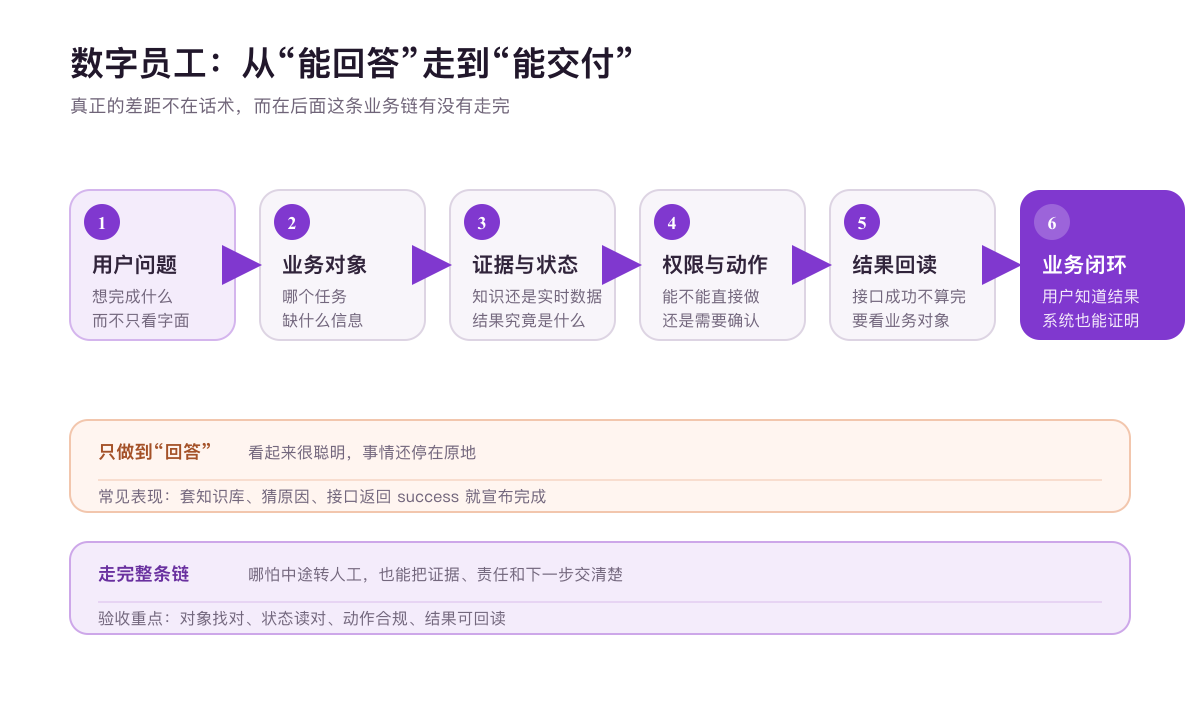
别先问机器人能做什么
很多项目一开始就会列能力清单:自动问答、自动查数、自动建单、自动生成报告。
看起来很完整,实际很容易跑偏。
因为“能查任务状态”这句话,至少有三种完全不同的理解:
- 能解释任务有哪些状态;
- 能读取某个任务的实时状态;
- 发现异常后,还能推动任务恢复。
第一种只需要知识库。第二种需要接系统。第三种已经涉及权限、写操作、失败恢复和责任人。
如果前面没说清楚,业务会以为交付的是第三种,研发可能只做了第一种。大家都很努力,最后还是会在验收会上面面相觑。
所以我更愿意先问:用户原本要完成什么事?现在怎么完成?卡在哪里?AI 加进来以后,哪一步真的会发生变化?
这几个问题没弄明白,模型选得再贵也只是把错误流程跑得更快。
摸底这件事,开会只够一半
业务访谈当然要做,但不能只靠访谈。
人在会议里描述的,通常是“正常情况下应该怎么做”。最费时间的,往往是那些不太好意思写进流程图的部分:缺字段了找谁补,接口挂了怎么绕,哪个状态其实没人敢认,最后是谁在群里吼一声把事情推下去。
这些细节不在需求表里,却决定数字员工能不能用。
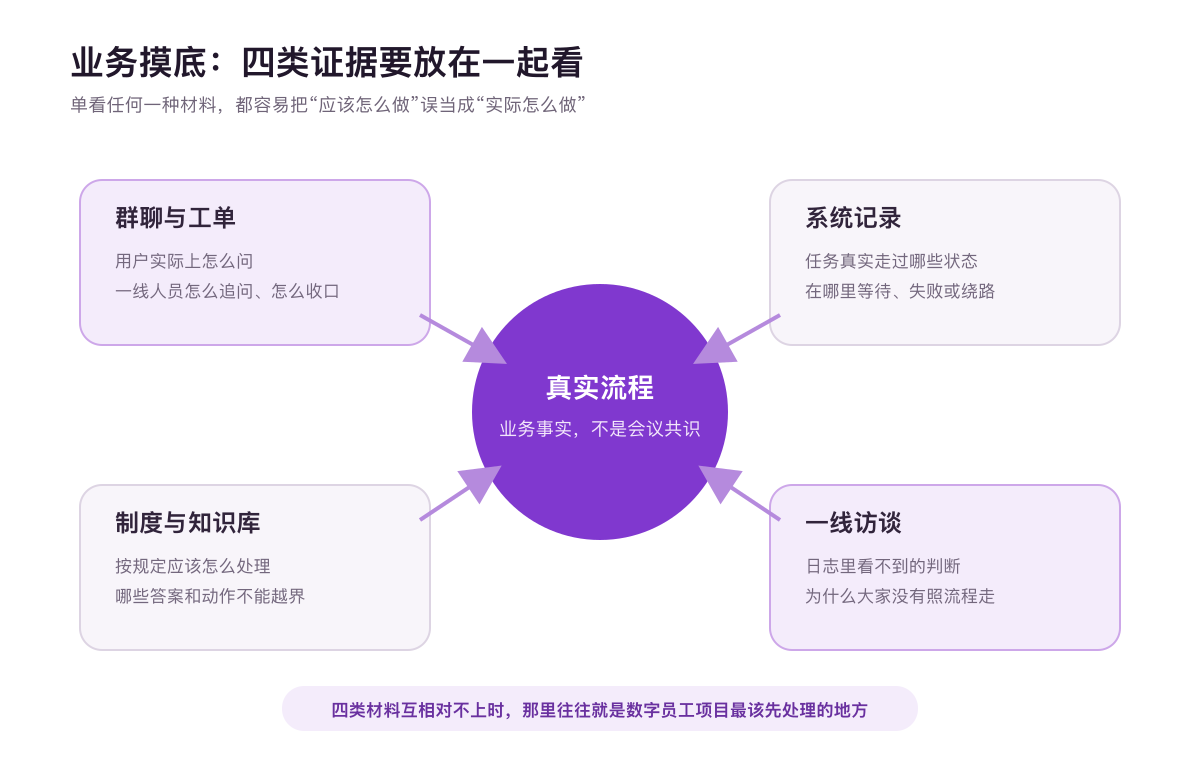
比较靠谱的做法,是把几类材料放在一起看:
- 看群聊和工单,知道用户实际会怎么问;
- 看系统记录,知道任务实际走过哪些状态;
- 看制度和知识库,知道按规定应该怎么处理;
- 再找一线同事聊,问清楚为什么现实里没有照规定走。
Microsoft 的 Process Mining也是这个思路:用事件记录还原流程,而不是只看一张静态状态表。
四类材料放在一起,经常会看到三个版本的流程:文档里的版本、系统里的版本、大家实际在用的版本。
数字员工要接的,是大家实际在用的版本;交付时又要想办法把它拉回一个可控、可审计的版本。
聊天记录不是现成的问答对
拿到群聊数据后,另一个常见动作是把问题和回复直接整理成知识库。
这一步可以做,但远远不够。
“这个能用吗?”可能是在问功能,也可能是在问权限,还可能是在排查故障。反过来,“昨天那个怎么还没好”“任务是不是卡住了”“进度怎么不动”,说的可能是同一件事。
如果只盯着字面,意图标签会越建越多,该做的动作还是不清楚。
一条有用的业务案例,至少要把业务对象、证据和动作说清楚:
- 用户想完成什么;
- 说的是哪个业务对象;
- 现有信息够不够;
- 答案应该来自知识还是实时数据;
- 可以直接做,还是需要用户确认;
- 做不了时交给谁;
- 看到什么结果,才算真的结束。
这些内容比“标准回复”重要得多。
标准回复写得再顺,如果查错了任务,或者把“已进入队列”说成“已经完成”,仍然是在认真地误导用户。
数字员工最难的部分,其实是边界
把案例整理到一定数量后,能力大致会分成几类:判断问题、读取信息、执行业务动作、交给人。
前两类通常比较容易。麻烦从“执行”开始。
系统知道用户想改配置,不代表它有权修改;接口可以调用,不代表当前用户可以调用;写入返回成功,也不代表最终业务对象已经变化。
ServiceNow 的安全说明会把调用权限、运行身份、数据访问和实际动作拆开处理。这一点很值得借鉴。
说白了,意图识别解决的是“用户想干什么”,权限解决的是这件事现在能不能让你干。两个问题不能混成一个。
项目里最好早点把下面几种动作分开:
- 可以直接回答或查询;
- 可以给建议,但要用户确认;
- 可以登记或派单,但不能代替责任人承诺;
- 风险太高,只能转人工。
这看起来不够“智能”,但比一个什么都敢答、什么都敢点的机器人靠谱多了。
最后到底要交付什么
数字员工不是一个页面,也不是一份 PRD。它更像一套新的业务运行方式,所以交付物会比较杂。
通常会留下这些东西:
- 哪些业务场景要做,哪些明确不做;
- 真实流程和证据,包括正常路径和各种绕路;
- 数字员工在不同场景里扮演什么角色;
- 哪些能力可以复用,哪些必须交给人;
- 每类任务怎么判断、怎么处理、怎么结束;
- 每一步对应哪个系统、什么数据、什么权限;
- 用哪些真实案例验收;
- 上线后谁维护知识、规则和评测集。
你可以把它们拆成九份文档,也可以合并成三四份。形式没那么重要。
重要的是:任意挑一个业务问题,都能一路追到它的处理规则、数据来源、执行动作、权限边界和验收证据。
如果追到一半断了,那里就是项目缺口。
“接口成功”往往是最危险的成功
很多工作流会停在接口返回 success。
但 success 的含义可能只是请求收到了。任务也许还在排队,可能部分失败,也可能产物已经生成但用户根本没有收到。
所以验收时,最好把几组容易混淆的状态拆开。
没有查到记录,不等于数值为零;查询成功但结果为空,也不等于系统不支持;没有权限,更不能包装成“暂时没有数据”。
同样,已入队、执行中、部分失败、已完成不是一回事。已生成、已送达、可使用,也不是一回事。
这些词看起来有点较真,但业务事故往往就藏在这些“不就差不多嘛”里面。
涉及写入、登记、派发和修改的动作,除了拿到调用回执,还要再次读取业务对象。人说“处理了”、机器人说“完成了”、用户回一句“谢谢”,都不算系统证据。
验收也别只比较最后那段回复是不是和标准答案一模一样。OpenAI 对内部数据 Agent 的介绍提到用人工整理的问题—答案和黄金查询持续评测。放到数字员工里,更值得检查的是:对象找对没有,状态读对没有,动作该不该做,结果有没有闭环。
别一上来就追求全自动
数字员工项目很容易被“全自动”三个字绑架。
但第一批场景不需要追求最复杂,先挑最容易验证的:边界清楚、重复出现、失败可以恢复、结果能从系统里读回来。
可以先让它查、让它建议,再让人确认。等案例和评测稳定了,再开放自动登记。高风险写操作,则继续保留明确授权和人工复核。
这不是保守,是在给高风险动作留下一张后悔药。
NIST AI RMF强调代表性测试、人工监督和安全失败。翻译成产品语言,就是机器人没把握时要会停、会问、会升级,不能为了显得聪明硬着头皮往下跑。
上线之后,工作才刚开始
知识会过期,流程会变,接口会换,用户还会发明新的提问方式。
如果项目上线后没人收集未识别问题、人工改判、工具失败和重复求助,三个月后它大概率会变成另一个需要人工照顾的系统。
KCS 方法强调在解决问题的过程中持续捕获、复用和改进知识。数字员工也应该这样运转:一次失败不只是修一个 Bug,还要留下案例,修规则,补评测,明确责任人。
回到开头那个卡在 80% 的任务。
一个合格的数字员工不一定能当场修好它,但至少应该知道去哪里查、缺什么信息、自己能做什么、什么时候该找人,以及用什么状态确认这件事真的结束了。
这才是“员工”和“聊天入口”的区别。
下一篇不再讲方法。我会直接拿这个案例往下拆,看看怎么从一句群消息做出一条能执行的工作流。