
你把一份 40 页的报告交给 Agent,问它:“这个季度和上个季度相比,发生了什么变化?”
几秒后,它给出一个百分比,再补上一段听起来很合理的解释。表达清楚,语气确定,句末还有 [1]、[2] 两个引用。
问题是:这个百分比到底来自第 18 页的财务表,还是某张图表的标题?检索找到的是不是另一个章节?模型看到的数字,有没有和正确的列名对应?
只要这些问题答不上来,我们仍然是在相信模型,只不过这次它的回答后面多了几个编号。
文档 Agent 真正要解决的,不只是“能从 PDF 中回答问题”,而是建立一条可以反向检查的证据链:从答案回到引用,从引用回到检索片段,再从片段回到原始页面。
这条链路中最容易被低估的,并不是模型,而是模型看到文档之前发生了什么。
一、很多“模型错误”,发生在模型读到文档之前
人打开 PDF,看到的是标题、段落、双栏、表格、脚注、图表和明确的阅读顺序。机器拿到的却不一定是这些结构。
一篇双栏论文,基础抽取工具可能先读完左栏第一行,接着跳到右栏第一行,把两段完全不同的内容拼在一起。财务表里的数字可能全部提取成功,却失去对应的行名和列名。图表可能只剩标题,扫描页甚至没有可直接读取的文字。
换个更直白的说法:模型还没有开始理解,证据就可能已经被抄错了。
想象一名研究助理整理报告。他把所有数字都记进了笔记,却把“本季度”和“上季度”的列头贴反。之后无论换一位多聪明的分析师,还是给他更多笔记,得到的都只会是对错误材料更完整的解释。
这也是为什么,有些看起来像检索或生成的问题,根因其实在解析环节。表格关系一旦被压平,向量表示无法凭空恢复数字属于哪一列;阅读顺序已经错乱,扩大上下文只会让模型看到更多顺序错误的文字。
所以,文档 Agent 的答案质量,首先受解析质量限制。“文件上传成功”或者“OCR 识别出了文字”,都不能证明文档已经变成可靠证据。
二、从 PDF 到答案,中间是一条证据加工链
原文案例使用了一套很容易理解的链路。
PDF 先被 LlamaParse 转成保留页面信息的 Markdown。随后,解析内容通过 Ollama 的 nomic-embed-text 转成向量,存入 LlamaIndex 的 VectorStoreIndex。索引被保存在本地,应用再次启动时不必重新构建。
用户提问后,系统默认找回四个最相关的内容片段,再交给本地运行的 qwen3:4b-instruct 组织答案。CitationQueryEngine 会把候选内容进一步切成引用片段,为它们分配编号,并要求模型在回答中使用 [1]、[2] 这样的标记。
可以把整个过程压缩成五步:
PDF 页面 → 保留结构与页码的解析内容 → 可检索的向量索引 → 带编号的证据片段 → 基于证据组织的答案
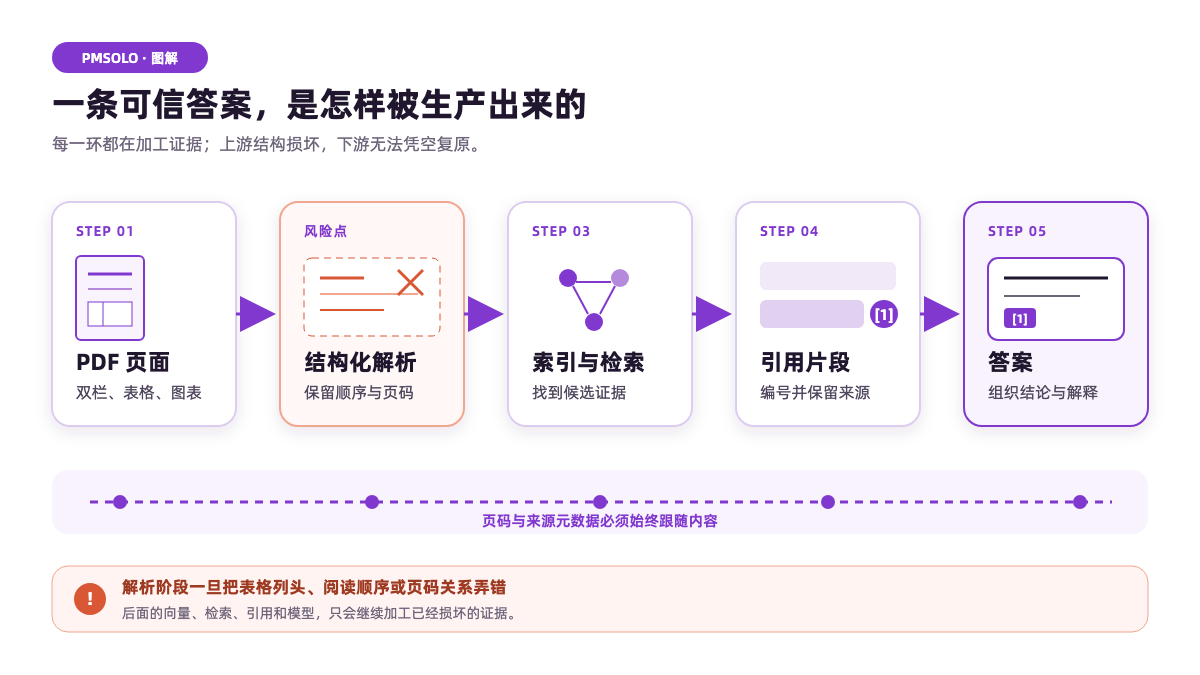
这里有个细节比工具名称更重要:页码元数据必须一直跟着内容走。
如果解析时保留了页码,但向量化或切片时把它丢掉,系统仍然能找到一段文字,却无法可靠说明这段文字在原 PDF 的什么位置。用户看到引用编号,也没有办法回到页面核验。
案例还把云端和本地能力做了拆分。PDF 会被发送到 LlamaParse 完成解析;之后的向量化、索引、检索和回答留在本地。文件哈希和解析缓存则避免同一份 PDF 被重复上传、重复消耗解析资源。
这可以降低重复问答成本,也缩小后续处理的数据外发范围。但描述这套方案时必须说准确:它是云端解析、本地问答,不是“全链路本地”。
三、检索不是越多越好,引用也不是越细越好
一份 100 页的报告,答案可能只藏在一张表和两段解释里。每次提问都把整份文档交给模型,不仅浪费上下文,还会增加无关信息。
向量检索的工作,是根据问题先挑出语义上最相关的局部内容。案例中的 similarity_top_k 控制一次召回多少个片段,默认值是 4。
召回太少,关键条件可能缺失;召回太多,模型会收到更多噪声,甚至遇到多个相似但口径不同的片段。Top 4 只是这个项目配置,不是所有文档 Agent 的标准答案。
候选内容被找回来以后,还要决定一条引用切多大。案例用 citation_chunk_size 把证据切成 512 个字符左右的引用块。
小块像一张内容很少的证据卡。用户很快就能看到哪句话支持结论,但金额、适用条件和例外说明可能被拆到不同卡片。大块能保留更多上下文,用户却要在一大片文字中寻找真正起作用的依据。
因此,引用颗粒度面对的是一个实际取舍:一边是核验精度,一边是上下文完整性。
参数不能靠抄。合同条款、财务表格、研究论文和技术手册的结构不同,问题需要的证据跨度也不同。产品验收时,要看的不是“有没有配置 Top K 和切片大小”,而是模型收到的证据是否完整、引用是否容易核验。
四、引用不等于正确,它只是让错误有机会被发现
假设环比答案来自一张财务表。
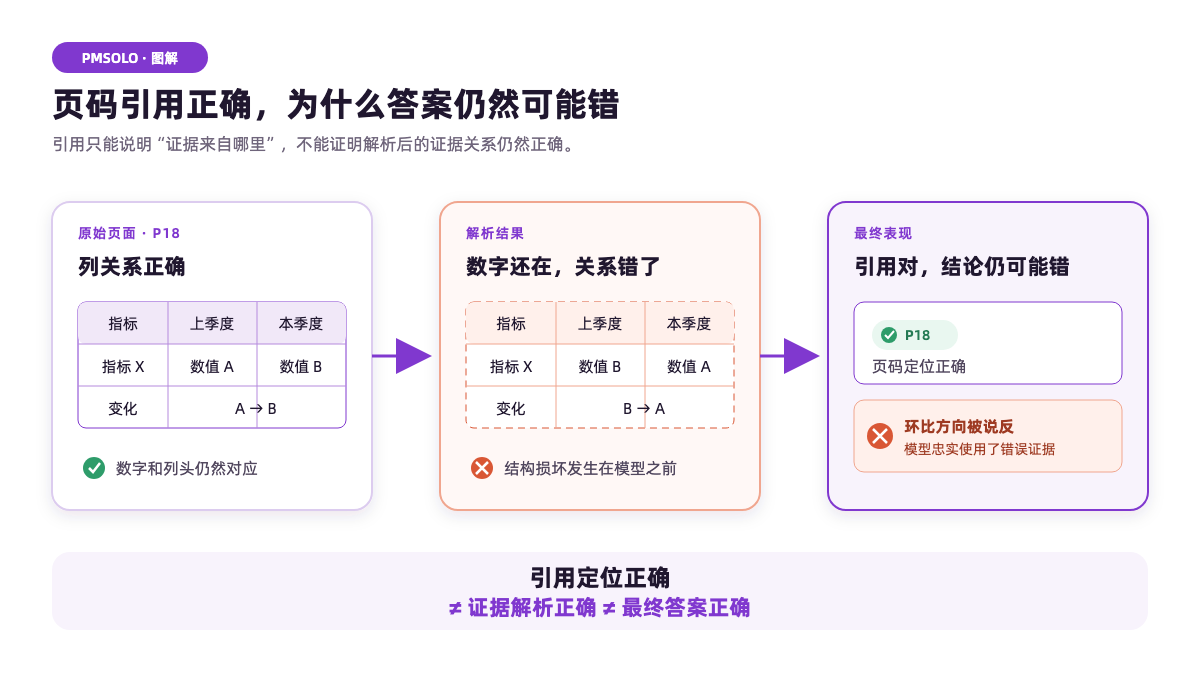
解析器提取到了所有数字,却把其中一个数字关联到错误的列头。检索仍然可能找到这张表所在的页面,因为关键词和数字都在那里。模型也能根据收到的内容给出一段通顺解释,最后附上正确页码。
页面找对了,答案仍然可能是错的。
引用在这里没有修复证据,它只是说明模型使用了哪段材料。引用不等于正确。只显示一个 [1],最多证明系统会生成引用格式;即使展示页码,也只能证明内容来自这一页,不能证明表格结构被正确还原。
真正有用的引用,应该允许用户看到模型实际收到的内容。原文案例展示了页码、检索文本、高亮查询词和相关度。使用者可以据此判断:
- 原始页面是不是被解析错了;
- 检索是不是找到了错误章节;
- 正确证据已经出现,但模型是不是理解错了。
系统依然可能犯错。区别在于,错误不再藏在答案后面。
这也是 Grounded 最容易被误解的地方。它不是给回答加一个“有出处”的装饰,而是让答案能够沿证据链被检查。引用是入口,解析正确的原文才是地基。
五、产品验收要从“答对了吗”升级为“错在哪里”
很多文档问答 Demo 的验收方法,是准备几道问题,看答案是否流畅、是否接近预期。这能检查演示效果,却不足以判断产品是否可靠。
沿着前面的证据链,至少需要单独检查四件事。
第一,检查解析保真,而不只是导入状态。
抽查应该覆盖产品真实面对的文档:双栏、复杂表格、扫描页、图表和脚注。检查的不只是“有没有文字”,还包括阅读顺序是否正确、表头和数字是否仍然对应、页码能否回到原文。
第二,把引用设计成可操作入口。
用户点击引用后,至少要看到对应页码和模型实际使用的原文。片段太短时,还需要展开附近上下文。否则,引用只是在界面上增加了可信感,没有降低核验成本。
第三,围绕任务调参数。
召回多少段、引用切多大,要根据文档结构和问题类型测试。验收时应保留问题、召回片段、引用和答案,才能判断错误究竟来自证据缺失、噪声过多,还是模型组织失败。
第四,准确说明数据边界。
哪些步骤发生在云端,哪些留在本地,原始 PDF、用户问题和索引分别存在哪里,都应该按实际链路描述。不能因为回答模型运行在本地,就忽略解析阶段的数据流向。
这四项判断指向同一个产品原则:可信系统不仅要尽量答对,还要让团队和用户知道为什么这样答,答错以后又该去哪里修。
六、先让失败可见,再谈更强的模型
文档 Agent 的价值,并不是替用户省掉所有判断,而是把查找和核验证据的成本降下来。
解析正确时,检索帮助用户从长文档里快速找到候选依据;引用把结论和依据连接起来;原文与页码让使用者完成最后确认。解析、检索或生成出错时,同一套界面又能暴露问题发生在哪一环。
原文还提出了几个后续方向:让引用直接打开对应 PDF 页面;证据太弱时拒绝回答;根据硬件条件更换更大的本地模型。这些能力并未在材料中证明已经实现,却提供了一个合理的建设顺序。
先保证页面结构没有在解析时丢失,再保证检索找到足够证据,然后让引用可以被检查,最后才是继续调整模型和回答效果。
因为一个无法核验的正确答案,只是这一次碰巧答对;一条能被检查、能定位错误的证据链,才是文档 Agent 持续改进的基础。