10 月 22 日,Google 开源了一个叫 Elephant-Goldfish Model(大象-金鱼模型,下文简称 EGM)的插件。发布博客开头说得很直白:AI 让写代码变快了,也让“垃圾产出”、bug 和会话上下文崩塌一起变快;没有护栏的速度,等于把错误也自动扩容。
这件事和 PM 关系很大。如果需求只是在对话框里讲给 Agent(能按指令自己动手执行任务的 AI 助手),讲到一半补一句、做出来不对再改,就会碰到同样的问题。EGM 给的思路是反过来:先把要做的东西写成一份 Spec(规格说明,即写清楚做什么、为什么、怎么算做完的文档),让一个完全没听过前情的 AI 来挑毛病,人拍板后再交给 Agent 动手。
下面先讲 EGM 怎么做,再讲交给 Agent 前要做的三个判断。
EGM 在做什么
EGM 用两种 AI 会话分工。“大象”是记性好的那个:一个长时间保留项目背景和历次决定的会话,只做设计,不写代码,由 AI 反过来追问你、和你争论各种取舍。“金鱼”是记性差的那个:每次都是不带此前对话的全新会话,只拿到设计文档和文档引用的源码等材料,用来检验规格。博客的理由是,金鱼和设计者没有共同的盲区,所以能当比较客观的批评者。目标是按下回车后,AI 第一次就写出你想要的代码。
插件把这个过程拆成三步,对应三个命令(下面用通用名称;在 Antigravity CLI 和 Claude Code 里要加 /egm: 前缀,Codex 从技能列表里选)。第一步 egm-brainstorm,讨论需求和取舍,规定不写代码,结果存成一份概念简报。第二步 egm-draft,把简报写成 Markdown 设计文档,内容包括问题定义、技术方案、考虑过的备选方案,以及具体到要改哪些文件的实施计划;仓库说明里提到,它会写完一节停下来等你反馈。第三步 egm-review,由金鱼来审。
博客描述的审查分三层。先是理解检查:金鱼读完整份文档,要把架构和意图复述回来,复述不对,就说明文档有歧义,得回去改。然后是对抗审查:几个金鱼扮演挑剔的技术评审,专找边界情况、隐藏依赖和逻辑漏洞,意见交回大象处理。最后是实施就绪检查:一个金鱼做通过或不通过的判断,看文件路径、数据结构(数据字段及其组织方式)、函数签名(函数名、输入参数和返回格式)这些信息是否齐全且没有歧义。仓库 README 则把审查描述为“五个阶段”,与博客的三步粒度不同;这里按博客的三步讲。
博客称这个插件最初为 Google 内部工程师开发,每天有数千名 Google 员工在用;这是 Google 的自述,没有附使用数据。仓库同时注明它“不是 Google 官方支持的产品”。
判断一:Spec 写到什么程度,才算能交出去
EGM 的审查标准里,有两条 PM 可以直接拿来用。
一是“别人能不能复述”。如果一个没参与讨论的人(或 AI)只看文档,讲不清你要做什么、为什么这么做,问题在文档,不在读者。很多需求文档靠的是会议里的默契,换个人就读不懂,交给 Agent 也一样。
二是“能不能判断做没做完”。EGM 最后一关问的是:落地需要的信息是否都在、是否没有歧义。对工程设计来说是文件路径和函数签名;我会把它翻译成 PM 需求里的验收条件、边界情况、明确不做的范围。
EGM 自己也没要求所有事都走全套。入门文档写着,流程不是硬性规定,能一次修好的简单 bug 就别硬套设计先行。按这个思路,我建议 Spec 的详细程度跟着改动风险走:改一句文案不必写设计文档,改计费规则就值得写。
判断二:谁来挑毛病
让“零上下文”的 AI 来审,好处是它看不到你脑子里没写下来的东西。和你聊了一下午的那个会话,已经被你说服了,很难发现文档里漏掉的前提。
这个做法也有边界,仓库文档写得很坦白:
- 金鱼审查依赖工具能开出全新上下文的子代理(由主 AI 派出去、独立干活的另一个 AI 会话);开不出来,EGM 会直接停止审查,不在同一个会话里凑合。独立版 Antigravity IDE 就因为这一点暂不支持。
- “全新会话”不等于完全干净。文档提醒,宿主工具可能仍会注入项目里的指令文件。
- 审查会给出“很多”意见,这是设计使然,由你挑相关的处理。
- 审查不替代测试,也不替代人的判断。在用代码仓库协作的团队里,入门文档还建议把设计文档做成 PR 发给同事评审,实现结果偏得离谱,就回去改设计文档再来。
所以金鱼的角色是帮人发现问题,拍板的始终是人。
判断三:停在文档,还是做原型、提 PR
Spec 写清楚之后,下一步并不总是“让 Agent 写生产代码(会上线给真实用户用的代码)”。Colin Matthews 在 Lenny’s Newsletter 的客座文章里把 PM 的“产品杠杆”分成三级:第一级用网页工具做原型,主要用来沟通,代码本身没价值,也和真实代码库无关;第二级让 Claude Code 或 Codex 基于真实代码库做原型,用的是产品里现成的组件和样式;第三级让 Agent 直接提 PR(代码合并请求),由工程师审核后合并进产品。
他的判断是:PM 没必要去当一个比团队更差的工程师,知道什么时候写文档、什么时候做原型、什么时候提 PR,和会不会做这些同样重要。他举的适合 PM 提 PR 的情况是文案修改、小的界面调整、复用现有后端接口(服务器已经提供的数据和能力入口)的视图改动;他也提醒,同样的改动可能需要新的基础设施或跨团队对接,这正是 PM 技术判断起作用的地方;我的建议是先拉工程师评估,不要当成小改动直接提 PR。
这篇文章后半部分讲“系统杠杆”的内容在付费墙后,公开部分只有一句定义:建立可重复的步骤,让 AI 稳定地产出高质量结果。本文没有引用付费部分。
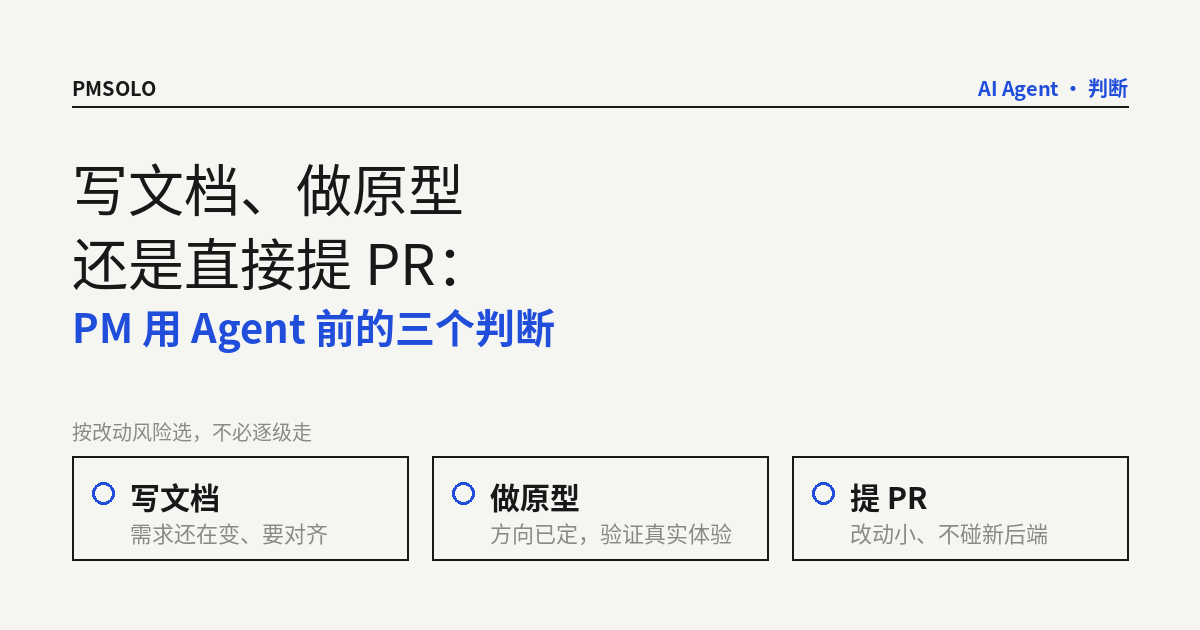
把两份材料放在一起,可以得到一个粗略的分工:需求还在变、要和人对齐时,停在 Spec 和网页原型;方向定了、要验证真实体验时,用真实代码库做原型;改动小、不碰新后端时,才考虑让 Agent 提 PR。无论哪一级,交出去之前都过一遍“别人能否复述、能否判断做完”。
不装插件,也能先这样做
先说来源边界:EGM 内置流程面向软件设计文档,其他文档可以用 egm-review-loop 自己配审查者和标准。下面的手动流程是我的建议,不是来源中的做法,例子也是假设场景。对多数 PM 来说,先照它的思路手动做一遍就行:
- 在一个对话里把需求聊透,要求 AI 先问你问题、不准直接给方案。
- 让它写成 Spec,至少包括:要解决的问题、做什么和明确不做什么、验收条件、已知的边界情况。
- 新开一个不带此前对话的会话,只贴 Spec(工具自动加载的项目规则仍可能存在),先让它复述你要做什么;复述偏了,就回去改文档。
- 再让它扮演挑剔的评审列漏洞,你逐条决定改还是不改,并把理由写回文档。
- 按改动大小选交付方式:文档、原型或 PR。
比如广告代理商要给内容 Agent 加一个“按品牌禁用词自动改写”的功能。假设新会话复述时说成了“删除禁用词”,就说明 Spec 没写清楚是改写还是删除、改写后要不要人审;这类问题在交给 Agent 之前发现,成本最低。
参考来源
- Google Open Source Blog:Introducing the Elephant-Goldfish Model plugin(2026-10-22):https://opensource.googleblog.com/2026/10/introducing-elephant-goldfish-model-plugin.html
- GitHub:google/elephant-goldfish-model(README、docs/getting_started.md、docs/harnesses.md):https://github.com/google/elephant-goldfish-model
- Lenny’s Newsletter:How top PMs increase their leverage with AI(Colin Matthews,2026-06-30,后半部分为付费内容):https://www.lennysnewsletter.com/p/how-top-pms-increase-their-leverage