
工具都接了,为什么还是查不到
上一篇,我们从群聊里整理出了案例卡、场景说明卡和待补能力清单。这一篇把清单交到技术同事面前,看看哪些已经能用,哪些还缺一段。
先拿“查排队”来说。用户给了链接,你要知道这是什么对象、对应哪次任务、现在到哪一步。装好一个数据库工具,或者接通日志系统,只完成了其中一部分。
我们做内部数字员工时,就遇到过这样的情况:知识库能列出来,真正检索时却报错;查到了一个叫 queueSize 的指标,细看发现是日志系统自己的缓冲队列。
这些是 2026 年 9 月 16 日的只读抽样结果,不是当前服务健康报告。本篇接着看当时怎样检查能力、交付包又怎样补上业务查询路径,不把“过去接过”写成“今天一定可用”。
| 这一篇准备什么 | 做完留下什么 | 下一篇怎么接着用 |
|---|---|---|
| 第一篇的场景说明、能力清单,一个允许查询的业务样例 | 工具清单、输入输出约定、成功与失败验证记录 | 把经过验证的步骤写进 Skill,而不是让模型临场猜接口 |
业务同事可以负责定义问题、确认结果;连接身份、SQL、鉴权和超时设置,需要相应技术同事参与。没有生产查询权限时,用批准的测试数据,不借别人的身份绕过去。
1. 先看这张能力框架图
先解释一个词:MCP 是给 AI 连接外部工具的一种方式。对外介绍这套方案时,可以先按下面五类能力理解,不必从内部产品名、数据库或服务地址讲起。
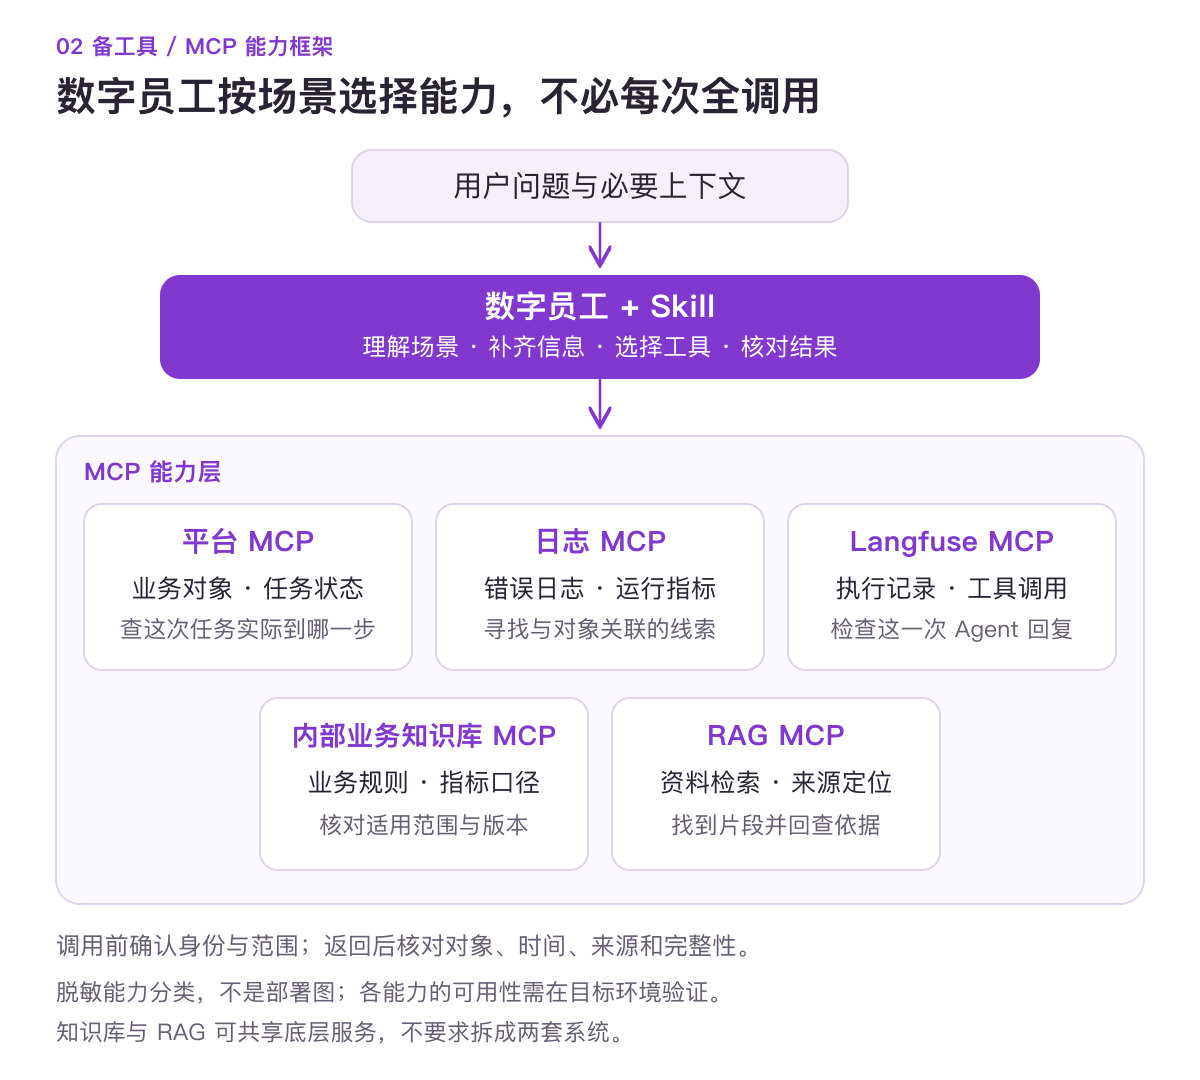
这是一张脱敏的能力框架图,不是物理部署图或已上线能力清单。图中的 MCP 名称统一表达能力入口,不逐一披露底层接入方式;具体环境是否可调用、权限是否正确、结果是否足以回答问题,仍要逐项验证。
平台 MCP:查业务对象和当前状态。 用户给出任务、报表或订阅的定位信息后,查询这个对象的实际记录。例如“这次任务还在跑,还是已经失败”。本篇只讨论只读能力,不从查询权限推导修改权限。
日志 MCP:找运行过程中的错误线索。 输入服务范围、时间窗口和可用关联标识,查看对应日志或指标。服务出现过错误,不代表这个错误属于用户的任务,关联证据还要补。
Langfuse MCP:检查 Agent 的具体执行过程。 围绕某次回复对应的运行记录,查看工具调用、耗时和反馈分析所需的证据。业务会话、回复和运行记录必须关联准确,不能拿相近时间的另一次运行解释当前问题。这里展示能力职责,不宣称本篇已经完成目标环境联调。
内部业务知识库 MCP:查业务规则和口径。 用来查术语定义、操作说明、指标口径和已整理的处理规则。回答时保留适用范围和版本日期,不能把历史规则当成实时状态。
RAG MCP:从资料中检索相关内容并定位来源。 RAG 在这里指先检索材料,再用找到的依据支持回答。要检查返回片段、来源及资料就绪状态,不能只看是否返回了一段文字。
内部业务知识库和 RAG 的区分,是为了讲清“查什么知识”与“怎样找到依据”。它们可以共享资料或底层服务,这张图不意味着必须再建两套系统。
拿“任务卡住了”串一次:先用平台能力查到用户这次任务;需要解释错误时,再找相关日志;涉及业务规则时查知识与来源;如果问题是数字员工自己答错了,再检查对应 Agent 运行记录。不要求每次问题都调用五类工具。
你自己的清单不必和我们一样。公司已有查询接口,就从接口开始;知识还在文件里,就先用允许访问的文件。不要为了练这套教材,先买齐一套平台。
可以复制下面这张卡,按第一篇的能力缺口逐项填。接入方式留到能力明确后再选。
【工具盘点卡】
对应场景 / 能力缺口:
具体要回答的业务问题:
已有系统和负责人:
接入方式(MCP / CLI / API / 文件 / 人工):
输入:
输出:
业务对象如何关联:
查询身份与允许范围:
结果时间与来源:
当前证据(配置存在 / 调用成功 / 业务样例验证通过):
失败时怎样返回、由谁接手:
待补内容及验证样例:
最后那个“当前证据”别省。它能防止会议里一句“有接口”,到了交付单上就变成“已验证可用”。
2. 知识库能打开,为什么检索还是失败?
历史实测里,我们对三个知识库分别调用了一次 hybrid_search,也就是混合检索入口,三次都返回了 HTTP 500 错误。
但同一轮里,Wiki 搜索、页面读取、两份来源元数据和部分片段又能读到。
更容易漏看的是:混合检索的外层结果为 isError=false,正文里却写着 Error executing hybrid_search: 500 Server Error: Internal Server Error。
如果只看工具有没有正常返回,或者只检查这个外层字段,就会把失败当成成功。接下来模型可能回复“没有找到相关知识”,把系统故障说成资料不存在。
我们实际能下的结论是:当时这个检索入口失败;另一些读取入口可用。根因尚未定位,也没有证明知识本身不存在。
这类验证,可以用一张很小的记录表完成。
| 你检查哪一步 | 当时看到什么 | 能说明什么 |
|---|---|---|
| 库列表 | 能拿到知识库信息 | 能发现库,不等于能检索 |
| 指定问题的检索 | 三个库各测一次都报 500 | 这些请求失败,不等于没有答案 |
| 来源读取 | 页面、元数据、部分片段可读 | 部分读取路径可用,不等于所有资料已覆盖 |
| 新资料状态 | 抽样三份为 processing / disabled | 当时未确认检索就绪,不代表永久故障 |
| 当前业务回答 | 还需要核对来源日期和适用范围 | 历史规则不能直接回答实时任务状态 |
读者动手时,可以选一个在指定文档里确实有答案的问题,把预期来源也记下来。然后分别检查:是否命中、片段是否支持答案、来源是否能回查、日期是否适用。再用批准的失败样例检查报错分支,不要通过破坏服务来制造失败。
这里有一个很实用的回复区别:
“检索服务这次报错,暂时无法验证相关资料。”
和:
“这次检索正常完成,但在指定范围内没有找到匹配内容。”
这两句后续动作不一样。前者要处理服务或走已经批准的替代路径,后者才是补关键词、补来源或请用户提供材料。替代路径不能自动扩大权限,也不能把未启用资料当成已验证检索结果。
3. 看到 queueSize,先问一句:谁的队列?
第二个坑更像正常结果,因为它确实返回了数字。
我们当时在日志服务中搜索与队列有关的指标,查到了 queueSize。查询返回了 8 组数据,各组末次值在 1 到 89 之间。只看字段名,很容易拿它回答“目前排了多少任务”。
但结果标签里的 processorType 是 BatchSpanProcessor 和 BatchLogRecordProcessor。这些标签指向链路、日志观测数据的处理缓冲区,不是用户业务任务的排队系统。
所以,这些值不能用于回答某个报表前面有多少任务,也不能推算还要等多久。
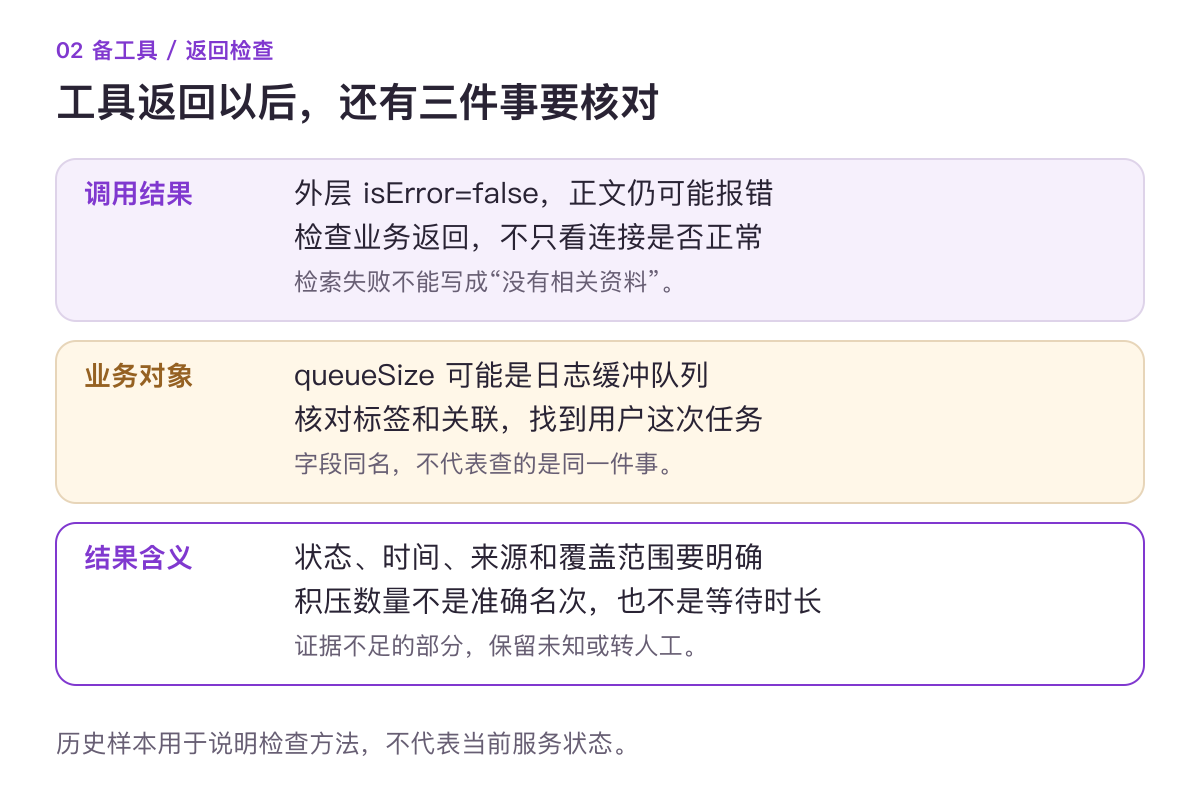
碰到一个可能有用的字段,先补完这四项:
【字段核对】
字段名及原始返回:
业务含义:统计的究竟是什么?由谁确认?
对象范围:哪个服务、任务、租户、类型或端口?
时间口径:哪个时区、窗口,最新值还是汇总值?
关联依据:为什么这条返回对应用户这次的问题?
填写不出来的地方,就是不能直接回复的地方。
日志也一样。那轮查询取了三条 ERROR 样本,里面有业务调用相关记录,也有日志导出失败。三条样本的 trace_id 和 span_id 都为空,尚未验证怎样从用户页面定位到同一次请求。
这时可以说“该服务在这个窗口存在错误,需要进一步关联”,不能说“找到了你这个任务失败的原因”。
注意,没发现结构化业务标识,不代表正文里一定没有线索,更不代表所有链路都缺这个字段。把已检查的范围记清楚,后续技术同事才知道从哪里接着查。
4. 真正要补的,常常是几段对象关联
第一篇的旧创编排队案例,能帮助我们提出“定位任务、查询进度”的需求。下面展示的是交付包里另一个真实分支:数据订阅任务查询。两者共享排查思路,但不能直接共用表名、入口和状态定义。
这份 Skill 的职责很窄:用户给出符合指定格式的订阅详情链接后,查到真实请求及底层任务,再解释当前状态。它不代替用户重试,不修改任务,也不承诺缺少依据的完成时间。
打开查询步骤,会发现它不是“拿链接里的 ID 去任务表查一次”那么简单。
| 查询层 | 找什么 | 需要留下的关联证据 |
|---|---|---|
| 订阅 | 链接对应的订阅记录及相关明细 | 当前订阅 ID、目标数据日期等必要上下文 |
| 发送记录 | 本次要追踪的请求 | request_id,以及单独记录的补偿请求 back_request_id |
| 元数据与映射 | 请求怎样连到底层任务明细 | 父请求、任务元数据、关联记录 |
| 底层明细 | 所有关联任务的状态和错误 | 每条明细 ID、状态、更新时间、必要错误信息 |
原步骤先读数据库时间和时区,再查订阅及最近 20 条发送记录。这 20 条是最近的记录,不是全部历史;如果目标不在其中,要么在许可范围内继续定位,要么明确覆盖不足,不能得出“从没执行过”。
拿到请求后,还要分别处理正常请求与补偿请求,并按底层明细 ID 去重统计。一个请求可能关联多条明细,只看第一条“成功”,会漏掉其他还在运行或失败的任务。
下面把原关联 SQL 的表名替换成教学别名,只展示关联结构。它不是可以复制进任意数据库执行的脚本:真实字段、权限和参数绑定需要技术同事按本库实现。
-- 教学别名:task_meta / task_request_mapping / request_detail
-- :request_id 必须来自已验证的当前订阅发送记录。
-- 此片段省略部署侧授权过滤,不得原样用于生产。
SELECT
    meta.request_id AS parent_request_id,
    detail.id AS detail_id,
    detail.status,
    detail.modify_time,
    detail.error_msg
FROM task_meta AS meta
JOIN task_request_mapping AS mapping ON meta.id = mapping.task_id
JOIN request_detail AS detail ON mapping.request_id = detail.id
WHERE meta.request_id = :request_id;
不写 SQL 也没关系,你要和技术确认的是:这几段关联有没有依据?如果一对多,是否全部拿到了?中间为空时,能知道断在哪一层吗?
原包对此有一个明确要求:关联查不到时,分别检查元数据和映射,不能直接把“没有关联记录”解释成“还在排队”。
还有三个容易误用的细节。
状态数字不能跨表照搬。 原包记录的一个明细表里,0/1/2/3 分别对应未开始、成功、失败、进行中,同时要求查询时重新检查字段注释。换一个表,不能继续套这套解释。
按创建时间数出前面的任务,不等于调度名次。 优先级、账号、重试、去重和 Worker 分配都可能改变执行顺序。Worker 是实际消费任务的执行进程。没有独立验证过的调度规则,就只能提供积压参考,不能告诉用户“你排第几个”。
“今天”也要说明口径。 原查询中“今日分布”统计的是今天创建的任务在查询时的状态,不是今天执行过或完成过的所有任务。历史未开始积压则需要另查,不能只看今天。
这些定义并不琐碎。少写一条,模型就多一个用常识替你解释的机会。
5. 把结果封装成一份工具约定
查到了正确记录,还需要告诉数字员工哪些字段可以回答用户,哪些只能辅助排查。
这里不要求你先开发新服务。先把约定写出来,再由技术决定复用现有 API、封装只读查询,还是通过 MCP 暴露。下面用“任务状态查询”填一份教学示例,字段名是建议,不代表原服务已经返回这套结构。
| 项目 | 示例约定 |
|---|---|
| 能力名称 | 查询指定业务对象的任务状态 |
| 输入 | 对象类型、已验证对象标识、必要时间条件;调用身份由可信服务确定 |
| 授权 | 服务端校验对象所属范围,模型不能自行指定别人的身份扩大查询 |
| 成功返回 | 对象、关联任务、状态含义、查询时间、数据更新时间、来源及覆盖是否完整 |
| 无匹配 | 在明确范围内正常查完,没有匹配记录;与查询失败分开 |
| 无权限 | 停止查询,不泄露范围外对象是否存在,不自动切换高权限账号 |
| 部分结果 | 明确尚未取全,不生成完整总数或“全部成功”结论 |
| 错误返回 | 可回查的错误标识和阶段;不直接暴露凭证、完整响应或敏感堆栈 |
| 不承担 | 修改、重试、加速、重启执行进程,以及无依据的完成时间预测 |
下面是合成的返回样例,时间、标识和状态只用于展示字段关系,没有连接真实业务系统。
{
  "result": "ok",
  "object": {"type": "subscription", "id": "demo-subscription-A"},
  "queried_at": "2026-09-20T10:00:00+08:00",
  "coverage": {"complete": true, "scope": "selected_request"},
  "tasks": [{
    "id": "demo-task-A",
    "state": "running",
    "state_definition": "目标系统已确认的进行中状态",
    "updated_at": "2026-09-20T09:59:00+08:00"
  }],
  "source": {"system": "demo-task-system", "reference": "demo-query-A"},
  "queue_position": null,
  "estimated_completion": null
}
这个样例里的 result=ok 只表示查询成功,state=running 才是业务任务状态。查询成功时,任务完全可能还没完成。两个空值表示没有提供可靠的名次和完成时间,不是排在第 0 位,也不是马上结束。
失败样例可以简单一些。同样是教学约定,不是通用 MCP 标准:
{
  "result": "tool_error",
  "stage": "task_lookup",
  "error_reference": "demo-error-A",
  "user_message": "本次状态查询失败,尚未确认任务状态"
}
无匹配、无权限、部分结果也要有明确类别,例如 no_match、access_denied、partial。具体名称可以换,但几种含义别塞进同一个空数组,让模型自己猜。
换成自己的系统时,复制这张约定单即可。填写时先只选一项能力,别一次性设计整个工具平台。
【工具约定单】
对应场景与能力名称:
一句话用途 / 不适用范围:
允许的输入及校验规则:
调用身份如何确定 / 对象权限在哪里校验:
从业务对象到目标记录的关联:
成功返回字段、业务含义和时间口径:
结果来源怎样回查:
分页、截断和覆盖完整性怎样表示:
无匹配 / 无权限 / 部分结果 / 系统失败分别怎样表示:
哪些操作明确不提供:
正常样例与预期结果:
失败样例与预期行为:
目标环境、负责人、验证日期:
仍未验证的项目:
6. 配置能复制,环境和验证不能省
迁移到另一个环境时,很容易只改一个 MCP 地址,然后运行检查。
这次交付包就有一处需要处理的绑定:MCP 地址既写在配置文件里,也被校验脚本按固定值检查。只换配置里的地址,校验仍会按原地址判断。
它说明的是原包带着内部环境约束,不是新地址一定错误。要把它整理成可复用版本,需要同步调整配置、校验逻辑、相关样例和说明;校验应检查允许的结构与策略,而不是继续认原来的内网地址。
另一个要核对的是超时。包内 YAML 分别写了 timeout: 600 和 connect_timeout: 60,并区分工具调用预算与初始连接预算。这是该交付包的配置记录,不是建议所有环境都照填,也不保证所有运行时版本都使用相同字段和单位。
交接说明还要求目标版本核对 HTTP 读取超时和一次运行的总预算。把某个数调大,并不等于其他环节也一起延长,更不能用无限等待掩盖卡住。
实际迁移时,可以逐项问:
- 工具运行在哪个环境,网络能到哪里,凭证由谁提供和保管?
- 配置字段和单位是否符合目标运行时?超时后返回什么,是否会自动重试?
- 工具名称和连接 ID 是否需要运行时发现,还是有稳定的业务别名?
- 模型调用的查询是不是只读?账号权限是否也被限制,而非只在提示词里写“不要修改”?
- 日志、样例和错误信息里有没有带出账号、令牌、回调地址或范围外数据?
原订阅 Skill 就要求动态发现连接,不沿用历史连接 ID。运行环境变了,过去的临时标识可能已指向别处或失效。
如果你的团队已经有稳定的 CLI 或 API,也不用为了这篇教材改成 MCP。先验证同一条业务链路能否查对;形式统一可以晚一点,证据和权限不能省。
7. 拿一个只读样例走完,再进入下一篇
到这里,验证顺序可以很具体:
- 业务同事选一个有权限查询、预期结果可独立核对的对象,记录环境与时间。
- 技术同事确认目标身份、最小只读权限、工具和连接,不先让模型自由查询整个库。
- 沿对象关联逐层取证;查询范围、分页、补偿请求和去重口径一并记录。
- 对照业务系统核验同一对象的状态,检查结果时间;不拿旧截图与新状态直接比较。
- 使用批准的测试样例或替身覆盖失败分支,不故意让生产服务报错。
- 将结果记入下面的检查表。缺哪项写待验证,不用“整体正常”盖过去。
| 验证样例 | 应看到什么 | 不应出现什么 |
|---|---|---|
| 正常查询 | 正确对象、状态含义、来源与时间可回查 | 用工具成功代替任务完成 |
| 无匹配 | 正常查询完成、范围明确、没有匹配记录 | 猜测正在排队或断言对象从不存在 |
| 无权限 | 明确停止,交给授权负责人 | 换高权限身份继续查或泄露他人对象 |
| 查询失败 | 保留错误定位,业务状态仍待确认 | 把失败说成“没有任务” |
| 多条明细/分页 | 全部取完再统计;否则标部分结果 | 用第一页或第一条代表全部 |
| 语义不符 | 识别日志缓冲队列与业务队列的区别 | 仅凭字段名给名次或等待时长 |
把测试环境、对象代号、预期结果、实际结果、证据位置、验证人和时间记在表旁。内部可回查位置与对外脱敏材料分开保存。
只有日志,没有任务查询,能先做吗? 可以辅助收集错误线索,但要收窄承诺。无法关联用户对象时,不能宣称查清了他这次的原因。
没有 MCP 能不能做数字员工? 能,先用团队已有且批准的工具。模型能否可靠调用、输入输出是否明确、权限是否受控,比接入方式的名字重要。
字段不知道怎么解释怎么办? 保留原始值供技术核对,向系统维护者确认语义和适用范围,不让模型根据英文名猜。
是不是只读就可以给整库权限? 不是。只读限制修改,数据范围还要靠账号、接口或授权过滤限制。用户无权看的内容,数字员工也不应替他查。
现在就要自动处理失败吗? 本篇只把查询做清楚。重试、修改和通知等动作分别需要授权与幂等设计,不能从“能查”顺手扩展成“能改”。
完成本篇时,你应该能拿出一张工具清单、一份填写完整的工具约定,以及带证据的成功和失败验证记录。如果某个接口还缺着,就把它留在能力清单里,第三篇不要假设它存在。
下一篇把这些已经查清楚的步骤写进第一份 Skill:什么情况进入、缺什么先问、调用哪个已验证工具、什么时候停下来,以及怎样把结果解释给用户。