
一个压缩包,目录很齐,测试也绿了。到这一步,大家很容易说:“数字员工已经做好了,找个人部署一下。”
我更愿意再问一句:这个“做好了”,具体做到哪里?
原交付包的实现状态文件里,明明白白写着 production_ready: false。下面逐项列出本地已经提供什么、服务器上还要接什么。这比一段“已完成全部功能”的汇报有用,因为接手的人知道下一步从哪里开始,也知道哪些不能算上线。
这一篇把前四篇的场景、工具、Skill、群聊规则收成一份交付记录。还会提供一个完全离线的小检查器。它只能帮你检查清单和文件,不能把未接通的能力检查成“生产可用”。
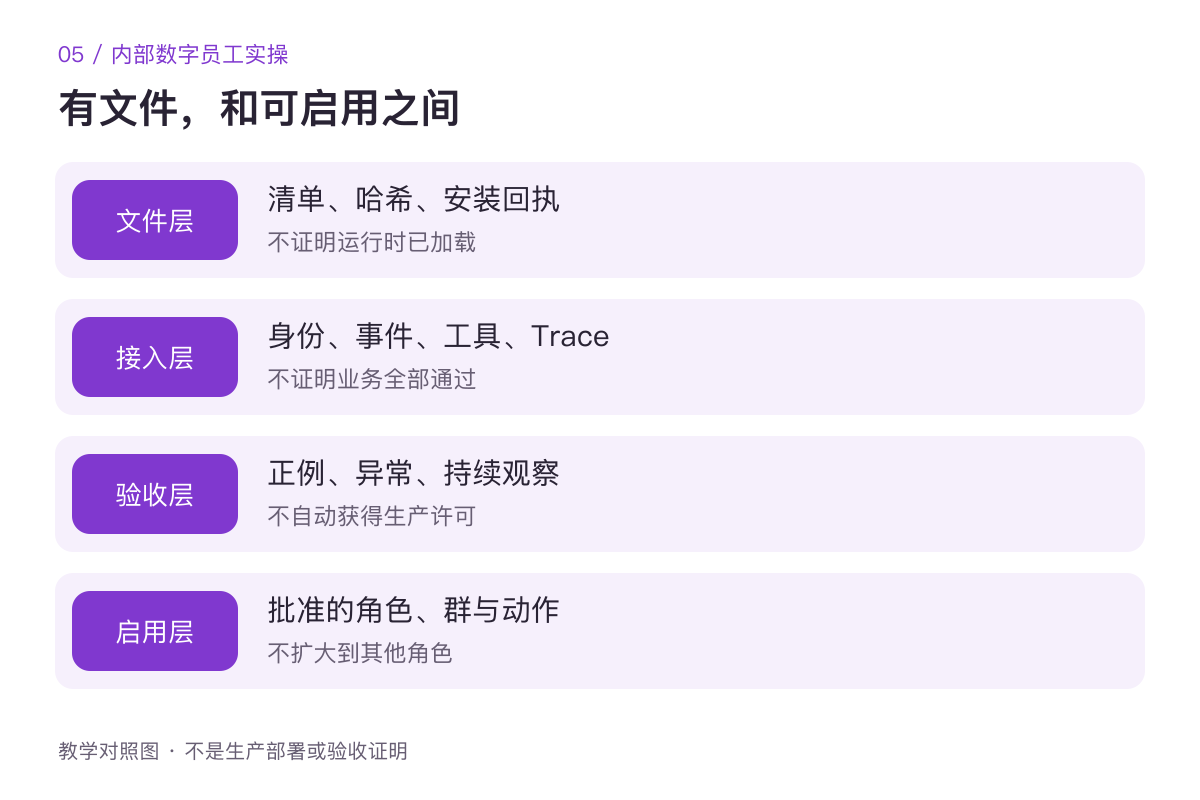
收到包、装好文件、线上生效,是不同的格子
先别问完成百分之多少,把状态分开记录。
| 状态 | 要看到什么 | 不能顺带宣布什么 |
|---|---|---|
| 已收到 | 来源、版本、文件清单和校验记录 | 文件内容一定可用 |
| 已安装 | 复制目标、安装回执、依赖就绪 | 运行时已经发现并加载 |
| 已配置 | 环境、应用、角色范围核对完成 | 真实权限和接口已验证 |
| 已集成 | 事件、工具、运行记录、回执链路接通 | 所有业务场景都通过 |
| 已验收 | 约定测试范围和失败场景有证据 | 获得扩大范围的许可 |
| 已启用 | 明确授权的角色、群和动作生效 | 其他角色也默认上线 |
这些格子允许并存不同状态。客服已完成测试群验收,PMO 还在影子运行,不矛盾。不要用一个总开关把它们一起点亮。
同样,安装脚本说需要重新加载,就是还需要重新加载。目录里有文件、运行时能找到 Skill、实际调用了目标版本,最好分别留证据。
拆包时,我先找这些东西
原交付包除了 Skill,还有配置示例、事件契约、控制程序、检查脚本、测试和实现状态。公开版可以按下面的结构整理。它是通用化的交付建议,不是内部包的原样文件路径。
delivery/
  README.md              从哪里开始,当前做到了哪一步
  manifest.json          版本、文件清单、明确的能力缺口
  skills/                工作说明、脚本、参考资料
  config/                无密钥的示例配置
  contracts/             事件、工具输入输出与回执约定
  tests/                 测试输入、期望结果和执行方法
  evidence/              经脱敏的验证记录
  rollback.md            停止、回退、核对未完成动作
目录只是入口。真正重要的是里面有没有把依赖交代清楚:需要什么运行版本?密钥从哪里注入?谁提供工具?依赖哪个已有服务?状态保存在哪?安装会覆盖什么?回退会不会丢反馈?
密钥不随包走,真实用户数据也不为了“方便复现”全部打进去。需要一条案例证明关联链路时,做最小化脱敏,保留判断所需字段即可。
如果只有原作者知道该先点哪里,这还不是一份能交接的包。找一位没参与开发的同事,按 README 从头走,卡住的位置就是文档需要补的地方。
做一个不会冒充上线验收的检查器
下面的小脚本是为本教材新写的教学工具,不依赖原交付包,也不联网。它做三件事:检查清单形状、核对清单里的文件有没有变化、要求你把缺口写出来。
准备 Python 3,在你的交付目录中新建 check_delivery.py,复制完整脚本:
import hashlib
import json
import re
import sys
from pathlib import Path

try:
    manifest = Path(sys.argv[1]).resolve()
    root = manifest.parent
    data = json.loads(manifest.read_text(encoding="utf-8"))
    if not isinstance(data.get("version"), str) or not data["version"].strip():
        raise ValueError("version is required")
    if data.get("production_ready") is not False:
        raise ValueError("this offline checker cannot assert production readiness")
    gaps = data.get("gaps")
    if not isinstance(gaps, list) or not gaps or not all(
        isinstance(x, str) and x.strip() for x in gaps
    ):
        raise ValueError("write at least one live verification gap")
    files = data.get("files")
    if not isinstance(files, dict) or not files:
        raise ValueError("files must be a non-empty map")
    for name, expected in files.items():
        rel = Path(name)
        target = (root / rel).resolve()
        if rel.is_absolute() or root not in target.parents:
            raise ValueError("path escapes package: " + name)
        if not isinstance(expected, str) or not re.fullmatch(r"[0-9a-f]{64}", expected):
            raise ValueError("invalid sha256: " + name)
        actual = hashlib.sha256(target.read_bytes()).hexdigest()
        if actual != expected:
            raise ValueError("hash mismatch: " + name)
    print(json.dumps({"offline_ok": True, "production_ready": False,
                      "files_checked": len(files), "gaps": gaps}, ensure_ascii=False))
except (IndexError, OSError, ValueError, TypeError, AttributeError) as error:
    print(json.dumps({"offline_ok": False, "error": str(error)}, ensure_ascii=False))
    sys.exit(2)
先拿一个文本文件练手,比如 README.md。在 macOS 终端运行 shasum -a 256 README.md,把输出最前面的 64 位小写哈希填进清单。Linux 常用 sha256sum README.md。这些命令只读取文件。
{
  "version": "0.1.0-teaching",
  "production_ready": false,
  "files": {
    "README.md": "替换为该文件的64位小写SHA256"
  },
  "gaps": ["目标环境尚未加载", "测试群尚未验收", "未获得生产启用授权"]
}
保存为 manifest.json,再运行:
python3 check_delivery.py manifest.json
没替换哈希时,失败是正常的。填对以后,应该返回 offline_ok:true 和 production_ready:false。然后故意改动 README 的一个字,再跑一次,应该报告 hash mismatch。
这就完成了一个很小但有用的练习:你能确认自己检查的是哪个版本,而不是凭印象说“我记得上次测过”。
它的限制也要一起交出去。检查器只检查清单列出的文件,不检查多出来的文件,不扫描凭证,不验证签名,也不判断业务逻辑。文件和哈希同时被改,它照样能通过。所以清单应来自可信交付渠道;完整性校验不等于来源可信,更不是安全审计。
包里的测试全绿,为什么还不能算上线
原包把很多确定性规则做成了测试,比如合法状态、去重、回执处理和异常分支。这些测试很有价值,但测试运行在哪里、输入是什么,要跟着结果一起写。
用模拟事件跑过卡片规则,不代表真实飞书回调字段已经适配;测试工具返回了假数据,不代表业务接口权限正确;本地能生成评价,不代表已把用户反馈写到正确的 Trace。
我会把验收拆成三层,每层只回答自己的问题:
| 层次 | 主要检查 | 留下的证据 |
|---|---|---|
| 离线包检查 | 文件、依赖、确定性规则、模拟异常 | 命令、版本、测试输入与输出 |
| 限定测试群 | 真实身份、事件、工具、回调、发送回读 | 实际事件及其对应结果 |
| 受控运行观察 | 真实数据时效、持续运行、失败恢复、打扰程度 | 按日期记录的结果和偏差 |
原项目的 PMO 交接要求包括五个工作日的影子验证。影子运行是先观察真实数据和拟发送内容,不默认向生产对象发通知。这是那个项目的验收门槛,不是每个机器人必须机械照抄五天。
更不能把“计划观察五天”写成“已观察五天”。每个工作日的数据批次、输入缺口、拟输出和人工判断都要有记录,遇到节假日也不能直接按日历凑数。
最容易翻车的地方,往往是“刚才到底发没发”
有一种故障特别值得演练:外部平台已经接受消息,本地进程却在保存回执之前崩溃了。
重启后,你看到本地没有成功记录。此时直接重发,可能给群里再来一条;直接标成功,也可能漏掉实际失败。正确状态通常是“未知,待核对”。
下一步优先用平台幂等键、回执或可查询的消息记录核对。无法证明时转人工,不通过换一个新 ID 假装它是新任务。这个设计只能降低重复风险,不能凭一个字段就承诺跨系统“绝对只执行一次”。
卡片更新失败也类似。原本应更新旧消息,不应该遇到失败就偷偷改成新发一张。先记录失败,核对消息和版本,再决定恢复动作。
这些都不是模型能力问题。要靠持久化状态、并发控制和恢复流程兜住。
一张交付单,把责任和缺口写清楚
这张表可以直接发给接手同事。先按示例填一遍,再替换成自己项目的证据。
【交付记录】
版本 / 文件校验:0.1.0-teaching,离线清单通过(教学示例)
本次角色与范围:一个只读查询角色,一个测试群
已完成:入口脚本、Skill 草稿、消息行为表
尚未完成:真实工具适配、事件接入、目标环境加载、业务验收
当前状态:文件准备完成;未启用

【实际交付时补齐】
安装目标、安装回执、重新加载证据:
应用、Profile、群白名单和权限确认人:
工具 / Trace / 回调适配负责人:
持久化状态和备份位置:
离线检查命令、版本、结果:
测试群正例和故障例、实际回执:
受控观察周期、数据覆盖、尚未通过项:
允许启用的动作、对象、频率和批准人:
故障停止开关、值班人、回滚版本:
外部发送结果未知时怎样核对:
回滚也要具体:先停自己负责的消费者和发送任务,核对在途动作,再按安装回执回退目标文件或配置。不要为了“回到干净状态”删除反馈、评分、消息索引或审计记录,它们正是你判断有没有重复处理的依据。
这一篇交出去的不是一句“可以上线”,而是一份别人能接得住的状态说明。等它进入受控运行,下一件事就来了:用户在群里纠正它,你怎么确认这次真的改好了?