假设一位投放运营让 Agent 做一件事:“查一下这个账户近七天的投放,找出消耗变化最大的计划,写一份摘要。”
如果这项功能要收费,报价单上该写什么?按一份摘要收,客户下单前容易算账,但查一个小账户和查上百条计划的成本可能相差很大。按每次查询收,后台多翻了两页,客户会问为什么同样一份报告更贵。按 Token 收,账可以算得更细,运营却很难提前知道读一份报表要用多少 Token。
这次调研看了 15 个产品。最能解释价格差异的是三个问题:谁买单,什么事件触发扣费,执行这个事件的成本由谁承担。 一份摘要足以把这三个问题分开。
用户收到一份摘要,后台可能跑了好几轮
模型先读取指令、历史上下文和可用工具,输出查询参数。输入和输出都按 Token 计量。Token 是模型切分和处理内容的单位,同样长度的中文报表,用不同模型处理,计量结果可能不同。
接下来,工具去查账户。运营看到一次“查近七天”,上游接口可能按日期拆批、按记录翻页,遇到超时还会重试。此时已经有三种数量:用户请求了一份摘要,Agent 发起了业务查询,系统实际打了若干次接口。每一种都能记,分别回答交付量、业务动作和后台消耗的问题。
报表返回后,模型把它当作下一轮输入,比较计划,再输出分析。若发现数据缺一天,还可能补查。最后生成文件也会占用运行环境和存储。对于一份长摘要,真正让账单变大的,有时是反复读入报表,而用户最后只看见几百字。
所以成本账里要保留各自的单位:输入与输出 Token、调用次数、取数范围、运行时间、存储量。先查清每项费率和归属,再谈能否加总。Manus 就明确把模型、虚拟机和第三方服务列为积分消耗因素,并公布过一次得分效率分析用掉 200 分的实例。这个数能说明那次任务花了多少分,却无法倒推出一次普通报表查询的 Token 价格。Manus 官方任务实例
七种收法,分别把哪部分不确定性留给谁?
订阅和席位回答“谁在什么周期买使用权”。其余多数规则回答“使用时按什么计量”。一家产品可以同时采用几种方式。下面的取舍是基于公开规则作的产品判断。
| 收费方式 | 客户能预估什么 | 产品团队要承担或解释什么 |
|---|---|---|
| 订阅或席位含额度,例如 WorkBuddy、Manus | 每月或每席的固定预算 | 重度用户是否集中耗尽额度,赠分何时失效,用尽怎么办 |
| 按模型用量,例如 TRAE 企业版、Runcell | 知道模型和输入输出量即可复算 | 业务用户很难在发起任务前预测上下文和输出长度 |
| 按工具动作,例如 Agentforce、Relevance AI | 一次查询或更新对应多少个计费动作 | 工具边界、失败重试,以及一个业务请求触发多个动作的原因 |
| 按工作流,例如 n8n | 知道每月执行几轮就能选档 | 简单流程和复杂流程可能花费不同,外接服务还可能另开账单 |
| 按数据或运行资源,例如 Firecrawl | 页数、结果数、浏览器分钟可逐项核对 | 返回错误页、启用高级提取或跨计费粒度时如何扣费 |
| 按结果,例如 Intercom Fin | 预算能对应到解决、转接等约定结果 | 谁验收,部分成功如何处理,失败尝试的成本由谁承担 |
| 混合,例如 Copilot Studio、Make | 能分别看到动作费和模型消耗 | 哪些费项可以叠加、哪些已包含,账单必须能解释 |
以按结果收费为例,Fin 的某些客服解决或流程转接收费 $0.99,每个对话最多计一个结果。“解决”也可以包括 AI 最后回答之后,用户没有继续求助。客户采购前要核对的,就是自己是否接受这个判定条件。市场上已经有按结果收费的产品,至于投放摘要是否适合,得看客户认可“拿到文件”“审核通过”还是“据此完成操作”。Fin 结果定义
一万输入、一千输出,究竟扣多少分?
先固定一次模型请求:10,000 个普通输入 Token,1,000 个输出 Token,无缓存。在三个平台上代入同样的 Token 数,可以看出算法差异。各自选用的模型和计费单位不同,这组结果不能直接用来排名。
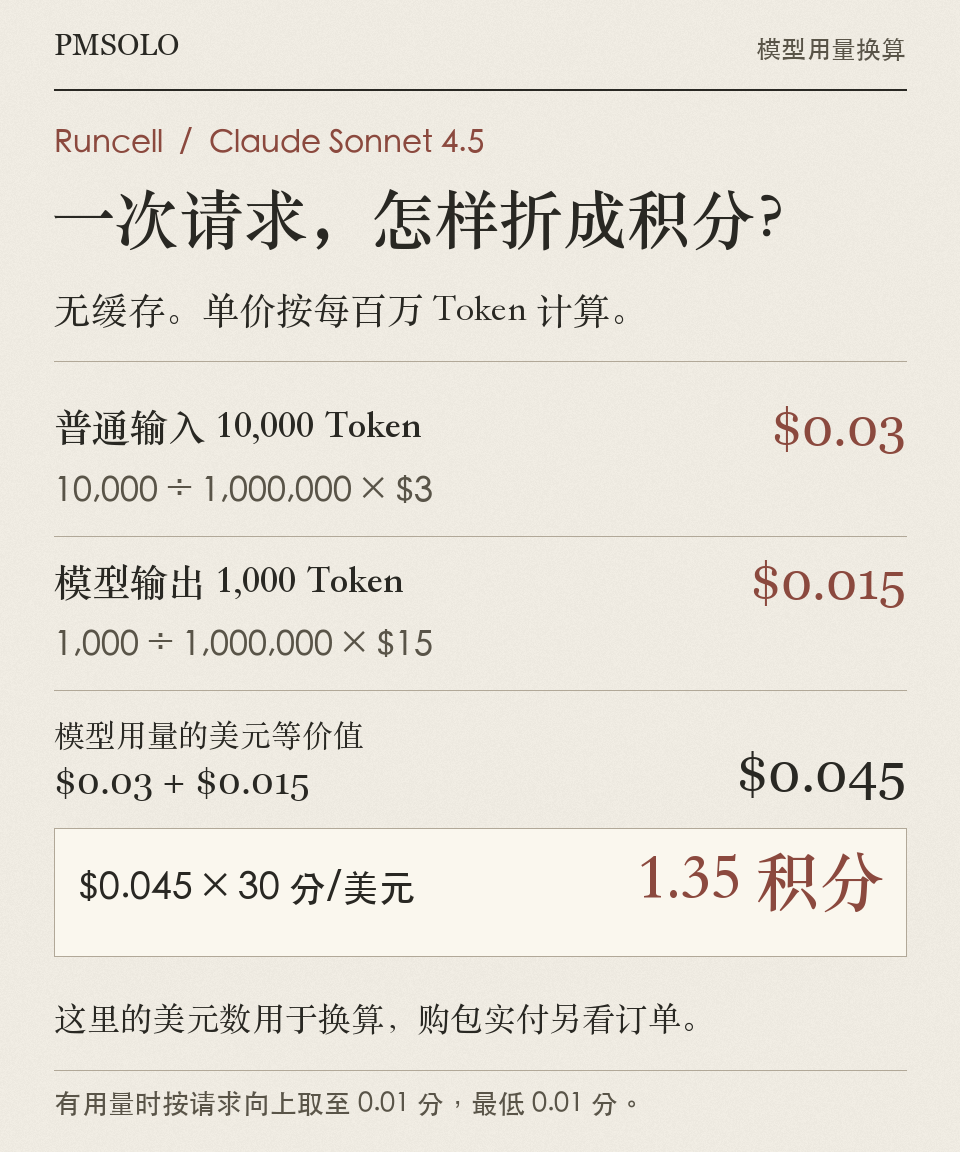
Runcell 先算模型用量的美元等价值,再折积分。 以 Claude Sonnet 4.5 为例,每百万普通输入 Token 为 $3,输出为 $15。输入算得 $0.03,输出算得 $0.015,合计 $0.045。每 $1 计费用量折 30 分,所以这一次扣 1.35 分。有计费用量时按请求向上取整到 0.01 分,最低 0.01 分。这里的美元数是平台换算的中间值,实际购包付款要另外看订单。Runcell 模型与舍入公式
Make 直接规定“一分能处理多少 Token”。 使用内置 AI Provider,理论模型积分等于“输入 Token ÷ 每分输入额度 + 输出 Token ÷ 每分输出额度”。同一组数据,GPT-5 nano 算得约 0.996 分,GPT-5 mini 约 4.978 分,Claude Sonnet 4.5 约 49.89 分。以 mini 为例,两个分母分别为 3,616 和 452。实际任务还要核对模块操作和舍入。若使用自带模型 Key,适用模块由 Make 收操作费,模型费用另付给模型商。Make 模型与模块费率
TRAE 企业版可直接算金额,缓存要先拆出来。 按前序调研记录的 Doubao-Seed-2.1-Turbo 参考价,每百万普通输入、缓存读取、输出分别为 ¥3、¥0.6、¥15。先代入上面那组无缓存请求,0.01 × ¥3 + 0.001 × ¥15 = ¥0.045。再换一组能看出缓存影响的数字:总输入 10 万,其中 4 万是缓存命中,输出 1 万。计算为 0.06 × ¥3 + 0.04 × ¥0.6 + 0.01 × ¥15 = ¥0.354。若把全部 10 万都按普通输入计,再加缓存费用,4 万个 Token 就多算了一次。适用企业模型档位与实际折扣需核对,此式不能代入个人会员积分。TRAE 企业版计费项
工具又是另一笔账。Salesforce 的一个标准 Agent Action 用 20 Flex Credits,按 $500/10 万分的标价包,两次动作折合 $0.20。Microsoft Copilot Studio 的一个适用 Agent Action 为 5 分,如果还用掉 2,000 个适用的计费推理 Token,按每千 10 分、无豁免,则共 25 分。两个产品都写 Action,只有查具体费率和包含项,才知道能否再加模型费。Salesforce 价格与方案 · Microsoft 功能与模型费率
账上的“每分多少钱”,至少有三种答案
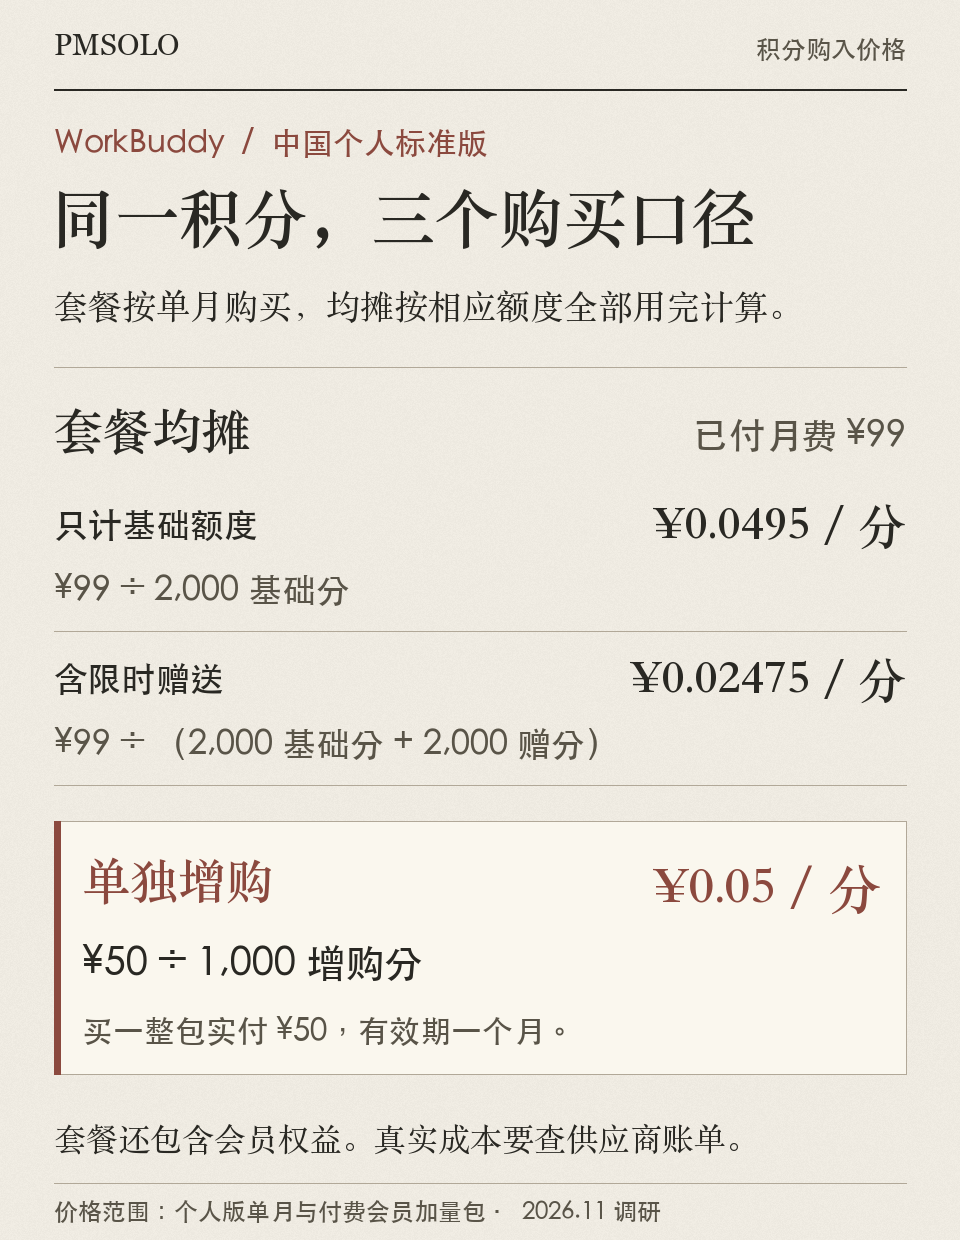
拿 WorkBuddy 中国个人标准版来算。单月购买 ¥99,含 2,000 基础积分,活动期另赠 2,000 分。付费会员另有 ¥50/1,000 分的加量包。三个除法都成立,但采购和财务该用哪一个,要看手上是什么问题。WorkBuddy 个人版定价
| 想知道什么 | 算法 | 结果 |
|---|---|---|
| 这份月包只看基础额度,用完平均多少钱 | ¥99 ÷ 2,000 | ¥0.0495/分 |
| 符合活动且把赠分也用完,月费平均多少钱 | ¥99 ÷ 4,000 | ¥0.02475/分 |
| 额度已用完,再买一包,新增资源单价多少 | ¥50 ÷ 1,000 | ¥0.05/分 |
前两行都把订阅费全部摊到了积分上,实际会员还买到了功能和容量。用户如果只用一半额度,已经支付的月费照旧。第三行决定下一包要付多少钱。至于平台为完成这次任务实际支付了多少,三行都缺采购合同和真实用量。
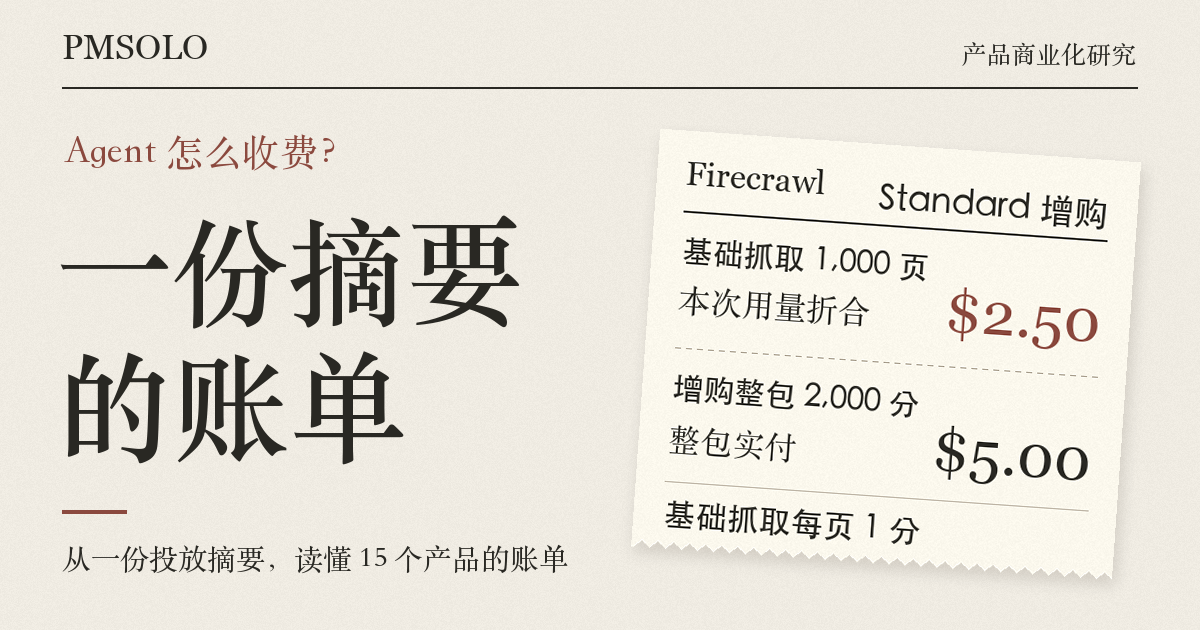
Firecrawl 把“花掉多少余额”和“这次要付多少钱”的区别说明得更直观。Standard 档 $5 增购 2,000 分。基础抓取 1,000 页,每页 1 分,用掉的余额折合 $2.50。如果需要新买整包,付款是 $5,余下 1,000 分留在账上。如果月包里还有足够额度,这次抓取也可能没有新增付款。三个数回答的是不同问题。Firecrawl 套餐及增购 · 端点计费
内部财务需要另一条公式:任务内部成本 = 各类实际用量 × 各自采购单价的合计 + 可归属的共享成本。客户应付金额则按订阅或席位费、合同约定的包外用量或增购费用、其他费用和抵扣结算。核对时要避免把同一笔预付余额在“购买”和“消耗”两处都算作新增付款。
15 个产品的定价档案
以下按 2026 年 11 月 13 日调研快照整理,个别端点在成稿时复核。人民币、美元、欧元保留原币。单月购买、连续包月、年付折月分别列出。动态页面不能单独证明某天对某个账号生效,实际下单还要核对资格、税费和合同。下文的“待核”表示本次材料未确认该项。
通用与办公助手
Manus(国际 · 个人及团队)。Free 每日刷新 300 积分。Pro 月付 $20 起含 4,000 分,$40 起含 8,000 分。Team 每席每月 $20 起,含团队管理。
运行模型、使用虚拟机、访问第三方 API 都会影响扣分。月积分按订阅周期刷新。平台技术问题导致任务失败可退分。Pro 首档满额均摊 $20 ÷ 4,000 = $0.005/分。官方公布的 NBA 得分效率图用掉 200 分,按此口径折合 $1。这次运行只说明该例的用量。
此处满额均摊只计月积分,未把每日赠分加进分母。
Team 每席额度、增购价及逐模型绝对费率待查。会员价格 · 积分与实际案例
WorkBuddy(中国 · 个人版)。体验版每月 500 分。标准、高级、旗舰单月分别 ¥99、¥199、¥999,连续包月分别 ¥70、¥140、¥700,连续包年分别 ¥672、¥1,344、¥6,720。
三档每月基础分分别为 2,000、4,000、20,000,限时另赠 2,000、5,000、30,000。WorkBuddy 与 CodeBuddy 同账号共享。付费会员加量包 ¥50/1,000 分,有效一个月。若主要使用自定义第三方模型,还要向模型商另付费。
赠送截止日、各模型的输入输出绝对费率、失败重试规则待查。个人版定价及增购 · 用量明细 · 自定义模型
TRAE Work(中国 · 个人会员。企业版另计)。Lite、Pro、Pro+、Ultra 单月分别 ¥49、¥99、¥239、¥699,连续包月 ¥45、¥89、¥219、¥629。对应月额度 2,000、4,000、12,000、40,000 分,云端并发 2、10、10、20。
会员及加量积分有效 31 天,加量 ¥50/1,000 分。内置模型扣分,自定义模型由提供商结算。底层模型错误或死循环可退分,客户端本地错误不退。个人版 Pro 的加量单价为 ¥0.05/分。企业版的内置模型另按普通输入、缓存读取和输出核算。
个人四档按单月满额均摊约为 ¥0.0245、¥0.02475、¥0.01992、¥0.017475/分。Pro 单月和企业 Token 定价分别适用不同账号。
个人账号适用的历史权益、逐模型 Token/积分及逐工具费率待查。个人套餐与退还规则 · 企业计费项
豆包工作伙伴 / aily(中国 · 飞书个人及企业)。个人连续包月 ¥68、¥200、¥500,额度分别为免费版的 5、20、50 倍。企业 AI 基础版 ¥9,900/年含 18 万点,或 ¥990/月含 1.5 万点。团队 ¥198/席/月或 ¥1,988/席/年,每席每月 2,000 点。
企业任务分模型、产物、工具三项。官方示例中 PPT 产物 10 点。aily 工作流每次调度 0.5 点,联网标准、单轮智能、深度智能检索分别 1、3、10 点/次。团队共享伙伴消耗创建者额度。企业年用量包 200 万点 ¥99,000,均摊 ¥0.0495/点。PPT 产物折合 ¥0.495,完整任务还需计入适用的模型和工具用量。
企业年包另有 600 万点 ¥297,000 和 2,000 万点 ¥990,000,三档满额均摊均为 ¥0.0495/点。基础年包 ¥0.055/点,基础月包 ¥0.066/点。官方将异常中断和模型限流分开处理,前者不收费,后者仍可能消耗额度。
独立「豆包工作」与飞书工作伙伴权益的对应关系、模型刊例价折点公式待查。版本权益与分项计费
QoderWork(国际站 · Qoder 个人订阅)。Lite、Pro、Pro+、Ultra 月付分别 $10、$20、$60、$200,基础额度分别为 1,000、2,000、6,000、20,000 分。
2026-10-21 开始的活动中,前三档符合条件的首次订阅加赠等量积分,赠分有效 30 天。团队和企业不参加。Ultra 首购无此加赠。四档基础额度均摊 $0.01/分,前三档首月含赠分满额均摊 $0.005/分。地区和购买资格决定适用权益。
原调研还记录了一则计划于 2027 年 9 月停用的服务变更公告。公告适用范围仍待核验,国际站活动权益不能直接当作中国版长期采购承诺。
活动结束日、中国版及团队全档价格、加购单价和服务变更影响范围待核。国际站活动与价格 · QoderWork 账号权益 · 服务变更公告
Grok Bot(国际 · 产品页个人档。生效时点待核)。个人页展示 Premium $30/月,Super $100/月,Ultra $200/月。后两档用量分别为 Premium 的 3.5 倍、12 倍。
订阅含每周用量,执行步数及 Token 会影响消耗。账户入口影响适用方案。缺少 Premium 的绝对周额度与单任务消耗,无法计算每个 Token、每次工具或每个任务的单价。
这些档位在调研日对应的账号体系、生效日期和团队价格待核。此处仅记录官方动态页展示。个人方案 · 用量 FAQ
工作流与数据平台
Relevance AI(国际 · Agent 平台)。企业方案询价。付费计划的组织管理员可增购 Action 或 Vendor Credits。文档列 $80/1,000 Actions 和 $20/10,000 Vendor Credits。
工具运行一次计一个 Action,失败也计。模型及适用工具服务消耗 Vendor Credits。自带 API Key 时,模型商另行结算。加购 Action 可结转至下一周期。按文档加购价,3 次工具运行折合 3 × $0.08 = $0.24,模型等供应商费用另算。并发限制影响排队。
旧价格页缓存曾列 $40/千次,与文档不一致。购买前核对结算页或书面报价。工具与增购规则 · 企业方案
n8n(国际 · Cloud 与自托管)。Cloud 年付折月 Starter €20 含 2,500 次/月,Pro €50 含 10,000 次/月。Business 自托管年付折月 €667 含 40,000 次/月,Enterprise 询价。
一次工作流执行计一次,内部步骤数不增加该次执行数。AI Assistant 有独立额度,接入外部模型还要核对模型账单。Cloud Starter 满额均摊 €20 ÷ 2,500 × 1,000 = €8/千次。Pro 为 €5/千次。Business 含不同部署和管理权益。
自托管 Business 按年付月均价满额折算为 €16.675/千次。企业自托管的算力和运维另算。
超额具体单价及客户接入模型的实际费用待核。部署、额度与年付价格
Dify Cloud(国际 · 云端工作空间)。Sandbox 含 200 message credits。Professional $59/月或 $590/年,5,000 分/月、3 名成员、5 GB。Team $159/月或 $1,590/年,10,000 分/月、50 名成员、20 GB。适用税费另加。
不同模型扣不同数量的 message credits。额度用完可接自己的模型 Key。知识库速率、文档数和容量另有限制。Professional 月付满额 $59 ÷ 5,000 = $0.0118/分。年付满额 $590 ÷ 12 ÷ 5,000 ≈ $0.00983/分。工作空间也提供应用、存储和协作。
Team 满额均摊,月付 $0.0159/分,年付 $0.01325/分。Team 多出的成员、文档和存储权益会同时影响选档。
积分结转、失败扣费和额外积分售价待查。工作空间套餐和模型额度
Firecrawl(国际 · 网页数据 API)。免费 1,000 分/月。Hobby、Standard、Growth、Scale 月付 $19、$99、$399、$749,分别含 5 千、10 万、50 万、100 万分。年付折月 $16、$83、$333、$599。
基础抓取 1 分/页,搜索 2 分/10 条结果,Interact 仅用代码时 2 分/浏览器分钟,使用提示词时 7 分/分钟,至少计一分钟。零数据保留另加 2 分/分钟。额外格式可加收。返回 403 或 404 文档也可能扣分。每 $5 四档分别增购 1,000、2,000、2,500、5,000 分。同样 1,000 个基础页,Standard 单月包用满时均摊 $0.99,使用加购余额折合 $2.50。高级抓取选项另计。
基础月包额度的结转也分档:Hobby、Standard、Growth 不结转,Scale 可结转一个月。取消订阅会使增购积分失效。按量付费可设支出上限,也可关闭。
Map 的端点文档列 1 分/调用,原调研记录部分表格按页表述。预算应以拟用端点为准。搜索按每 10 条向上取整,11 条结果用 4 分。订阅与加量 · 端点与失败计费
Make(国际 · 自动化及内置 AI Provider)。按套餐购买 credits。常规非 AI 模块通常每次操作 1 分,特殊模块另有规则。各地区、档位和额度对应的完整售价待核。
内置模型分别规定每积分可处理的输入与输出 Token。自带模型时,适用模块按操作扣平台积分,模型商另行结算。GPT-5 mini,10,000 输入和 1,000 输出的理论模型积分 = 10,000 ÷ 3,616 + 1,000 ÷ 452 ≈ 4.98。实际账单还取决于操作与舍入。
目标套餐实价、具体模块舍入、失败或重试如何入账待核。模块与模型费率 · 方案入口
模型、动作与结果
Runcell(国际 · Agent / Chat 模型消耗)。模型每 $1 计费等价值折 30 分。请求有计费用量时,最低 0.01 分,向上取整到 0.01 分。订阅档位和附带权益待核。
同模型的普通输入、缓存读取、缓存写入和输出分别计算。若总输入已含缓存,先剔除缓存部分再计普通输入。Claude Sonnet 4.5 普通输入 $3/百万 Token、输出 $15/百万 Token。无缓存的 10,000 输入与 1,000 输出合计 $0.045 等价值,扣 1.35 分。
美元等价值用于换算,实际采购合同、套餐增购价和同任务其他功能费用待核。Token 公式、舍入与缓存 · 套餐入口
Microsoft Copilot Studio(美国站 · 指定许可证与功能)。独立租户容量包 $200/包/月,含 25,000 Copilot Credits。另有按量结算、预购和 Microsoft 365 许可证内的适用权益。
经典回答 1 分、生成式回答 2 分、Agent Action 5 分。指定推理模型按每千计费 Token 10 分另计。不同许可证及运行方式有豁免或独立费率。假设一个适用的 Agent Action 同时用了 2,000 个计费推理 Token,无豁免,合计 5 + 2,000 ÷ 1,000 × 10 = 25 分。
目标租户许可证、运行方式、地区单价与豁免条件仍需逐项核对。功能与推理模型费率 · 美国站容量包
Salesforce Agentforce(美国站 · 企业 Flex Credits)。Flex Credits 标价 $500/100,000 分。另有 $2/对话及按用户购买的方案,适用功能和合同不同。
标准 Agent Action 20 分,Voice Action 30 分。一次客户请求可触发多个独立动作。两个标准 Action = 40 分。按该积分包标价折合 40 × ($500 ÷ 100,000) = $0.20。不同动作按适用价目表核算。
失败、退款、其他服务及合同折扣待核。固定 Action 不能推导出内部 Token 数。企业方案 · Flex Credits 价目表
Intercom Fin(国际 · 客服与销售 Agent)。客服解决、符合条件的流程转接等 $0.99/结果,部分销售线索资格判定 $9.99/结果。席位、渠道或最低承诺取决于方案。
每次会话最多收一个结果。客服解决可以包括 AI 最后回复后,用户未再求助的情形。需先确认可计费结果如何判定。100 个适用 $0.99 的结果 = $99 的结果费。该数额未包含可能发生的席位或渠道费用。
特定合同的最低承诺、争议与退款细则待核。结果费率无法揭示后台实际推理成本。结果定义及费率 · Fin 与平台套餐
选档时再看额度用尽之后
只比较每分单价会漏掉两类影响:高峰期能不能继续运行,已经付钱的余额能不能继续使用。以下条款会直接改变预算或交付时间。
| 产品 | 采购时要代入的条件 |
|---|---|
| Manus | 免费版 1 个并发、2 个定时任务。余额不足通常无法发起新任务,按步结算可能短暂出现负数。增购积分需在有效付费订阅下使用。积分规则 |
| WorkBuddy | 项目数、成员、资料库容量和自动任务也随档位变化。三档按单月价、用完基础及限时赠分,均摊依次约 ¥0.02475、¥0.02211、¥0.01998/分。加量包生效后不退款。个人版权益 |
| Relevance AI | 套餐内 Actions 周期重置,额外购买的 Actions 能带到下一周期。Vendor Credits 在订阅有效期间可结转。组织管理员购买,工具失败照计 Action。结转与增购 |
| QoderWork | 与 Qoder 系列共享账号、积分和权益,其他产品的使用也会占用同一余额。活动页列续费四档分别赠 500、1,000、2,000、3,000 分,升级到 Pro、Pro+、Ultra 分别赠 1,000、2,000、3,000 分。首购翻倍有不同资格。账号权益 · 活动细则 |
| n8n | Starter 的 AI Assistant 另有每月 1,600 分,Pro 随档位变化。这些额度不结转。Business 和 Enterprise 超额可能继续执行并产生费用,具体超额单价需看合同。方案与超额说明 |
| Dify Cloud | Professional 最多 500 份知识文档,Team 为 1,000 份。即便模型还有余额,存储到限也会阻止上传新文档。工作空间容量 |
| Intercom Fin | 上述结果费率用于官方所列 Intercom 聊天与邮件渠道。Voice 单独询价,采购时还需对齐席位和最低承诺。结果收费范围 |
其余未查清项也会影响比较。模型“消耗倍率”如果只给相对数字,缺少基准费率、模型路由和输入输出构成,仍算不出每百万 Token 扣多少分。并发满了可能排队,频率或容量也可能来自上游技术限制,不能一概记为额度用尽。对这些问题,采购核对需要的是目标账号的用量明细、结算页或书面合同。
如何把这份采购比较用在棱镜上?
棱镜面向投放运营。同一个“查询”可能是读昨天已有的报表,也可能触发跨账户补采。若今天就给它们统一定价,最先遇到的问题会是:为什么复用已有数据和重新向上游取数算同一笔?为什么工具超时重试,客户要再付一次?
现有 W45 需求提供了一个起点。它要求展示五项项目用量:模型 Token、工具调用、业务数据获取、定时任务和存储。工具按一次实际业务执行计,内部翻页、自动重试不增加面向用户的主次数。业务数据获取按数据类型 × 数据日期 × 业务对象记录。同样查七天报表,由 Agent 调用外部查询工具,记一次工具执行,返回的数据不重复记入业务数据获取。如果由订阅、业务功能或 RPA(机器人流程自动化)发起获取,即便底层调用同一个工具,也按业务获取工作单元统计。读取旧报表、重新下载和导出都不新增获取任务。业务获取重试、补采按原业务规则去重。
时间也要对齐。默认展示本月,可切累计。模型、工具和定时执行按发生时间,取数按数据日期,存储取采集时点的快照。未接入的项目显示“暂未统计”,已接入且确实无用量才显示 0。这些是需求口径,后台回传、启用工具、取数映射和无归属存储仍要验证。现阶段优先把用量展示清楚,新额度、提醒和超额拦截另作商业决策。
下一步可以选一项任务做影子账单:照拟议规则计算账单,只用于比较,不向客户扣费。就用开头的近七天投放摘要,先写下完成条件,例如覆盖指定账户和日期、给出变化最大的计划、关键数字可回查。然后用同一任务编号串起以下四组证据。
| 要回答的问题 | 建议留什么证据 |
|---|---|
| 一次请求实际跑了什么 | 模型及价格版本、普通输入/输出/缓存、工具及上游请求、取数对象和日期。并发和排队另记。 |
| 最终交付花了多少 | 供应商账单、折扣、运行时长、存储归属、失败重试、人工修正。公共资源暂无法归属的单列。 |
| 成本波动来自哪里 | 按账户数、报表规模和难度分层,比较成功率、每次尝试成本、每份合格摘要的成本,以及中位数、第 90 和第 95 百分位。样本不足的层保留样本数。 |
| 客户会看到什么 | 同一批任务分别试算按资源、按标准业务动作、按订阅含额度收费。让运营检查能否提前估价,让财务检查重度项目和失败任务的成本覆盖。 |
同一动作的成本分布稳定,客户又能理解“一份合格摘要”,可以继续讨论按动作收费。客户用量稳定、预算按月审批,可以试订阅含额度。取数费用主要随账户数和日期跨度变化,可以把这些条件写入档位。结果能复核、失败责任约得清楚,才有依据进一步试按结果结算。
如果棱镜考虑把多类资源统一显示为积分,先在试算表里写明 1 分对客售价、各类事件扣几分、哪些费用已包含、哪些抵扣先用,以及费率版本和生效日。例如一次账户查询已含基础取数,就不能再把内部翻页按独立动作收费。让同一批已完成任务同时生成资源明细、积分账和模拟应付金额,检查重试、包内抵扣和大账户的账能否逐笔勾上。
项目数、席位、接入账户数、并发和运行时长可以作为套餐权益候选。图片、视频或文档产物也可能适合分档,但要先核实运行成本、产物类型和现有采集能力。只有文件数量,无法说明模型消耗或交付价值。
财务可以用目标收入 = 已核实成本 ÷(1 − 目标毛利率)检查一套方案。举一个纯演算:假设模型 ¥0.30、取数 ¥0.20、算力 ¥0.10、其他分摊 ¥0.10,总成本 ¥0.70。若假设目标毛利率为 50%,对应的目标收入是 ¥1.40。两个假设都需要实际合同、任务样本和商业决策替换,不能写进棱镜报价单。
采购竞品时,我会逐项核对八件事:产品和地区、购买方式、套餐权益、计量事件、失败与超额、额度归属与结算、价格计算口径,以及这套规则对客户预算和供应商成本的影响。前七项可以找文档、订单和日志作证。最后一项要拿真实客户的用量和反馈来验证。
落到棱镜,最有价值的第一笔数据,是同一份需求在轻量账户和复杂账户上各花了多少,差额落在哪一步。如果差额主要在上游取数,按 Token 定价解释不了账单。如果重试集中在某个工具,先修工具可能比调整套餐更划算。这两种情况,需要的是同一组任务日志和供应商账单,结论却会把团队带向不同的工作。