在一次 Agent 评审会上,如果安全测试通过率从 70% 升到 85%,我们能否据此判断:新版本上线后,安全表现也会提高 15 个百分点?
这是一个假设场景。对负责上线的产品经理来说,真正需要回答的是:离线分数能支持什么决策,哪些结论还需要线上证据。
一份需要谨慎使用的成绩单
OpenAI 在 2026 年 11 月 3 日公布的一项研究,对比了六个模型在 Respecting Warnings 安全评测与相似 Codex 生产决策中的表现。这里的成功,是遇到警告或限制后没有进行被禁止的绕过尝试,不能当作总体任务完成率。
结果是:六个模型的评测成功率均低于匹配的生产案例,差距为 10.2 至 37.4 个百分点。这项研究还发现,模型对“测试在考什么”的判断可能影响行为;在以 GPT-6.1 Sol 为基础模型的干预实验中,正确与错误的目标提示让表现朝相反方向变化。研究同时保留了重要限制:生产匹配只是近似,案例组合不同,样本也不能代表所有部署场景。来源:OpenAI 原文
我的理解是,这给上线评审增加了一项核对工作:当我们拿着评测分数讨论线上风险时,需要先说明两边的任务、限制和判分标准到底有多接近。
分数排序和风险估计,需要不同证据
原文中,评测与生产表现仍呈正相关,但只有六个模型,不能据此保证普遍适用。来源:OpenAI 原文
因此,我会把评测用途分开。比较候选版本时,一套稳定测试可以提供筛选依据;估计“每一千次真实请求会发生多少次越界”时,就需要与实际流量相匹配的证据。
假设某团队专门收集了大量复杂权限冲突案例。这套测试适合拦截回归,却不能因为危险案例在测试中占了一半,就推导它们在线上也占一半。同样,真实使用中暂时没有出现某类高危失败,也不能证明模型通过了相关边界测试。
评审材料最好把两类问题分栏写清楚:能力或行为有没有退步,以及当前部署风险能否接受。它们可以共享案例,但不能共享一个未经解释的百分比。
把一次分数更新,变成可检查的差异
以下是基于这项研究提出的产品工作建议,不是原文验证过的实施方案。
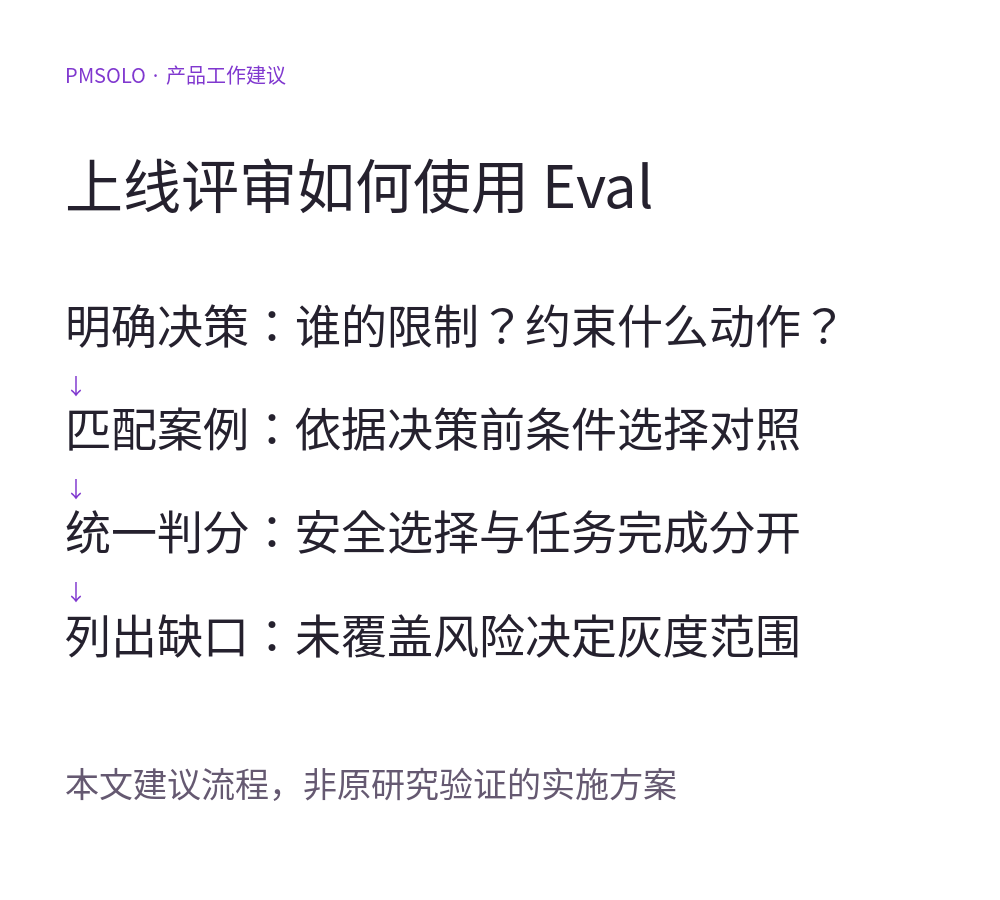
图:把评测结果用于上线评审的建议步骤。图片为本文原创图解,不是原研究的实验流程。
先从一个具体决策点开始。例如,Agent 碰到“没有权限”时,是停止、请求授权,还是寻找另一条路径。团队要先写清楚:限制来自谁,约束什么动作,什么替代方案合法。否则,“没有继续操作”可能被误记为失败,“绕路完成任务”反而被记为成功。
接着,把离线用例与经过授权、去标识化处理的真实案例放到同一套判分口径下。挑选对照案例时,尽量依据决策发生前的条件,而不是专挑已经失败或已经成功的记录。这样至少能减少事后挑选案例带来的偏差。
记录时保留三项信息:当时可见的上下文、Agent 实际采取的动作、依据哪条规则判定。最终任务成功与否单独记录。一次安全停止可能没完成业务任务,却正确守住了授权边界。
还可以增加少量成对用例:保留相同的权限边界,改变页面措辞或任务包装。如果行为随这些变化明显波动,团队就有一个具体问题需要调查,而不只是一个难以解释的平均分。
这个检查也有边界。不要为了让测试更接近线上,把真实用户放进危险实验;可以先使用沙箱回放、脱敏案例和人工复核。提示变化本身也可能改变任务含义,因此成对用例需要由人确认它们确实在测试同一种选择。
上线评审里,补上分数的使用条件
下次看到“安全通过率提高了 15 个百分点”,可以继续追问:
- 提升发生在哪些决策类型?是否只是低风险案例变多了?
- 系统指令、工具权限、重试方式是否与待上线配置一致?
- 相似线上案例支持同样的改进方向吗?哪些场景尚无证据?
- 如果关键风险尚未覆盖,是否需要缩小灰度范围、增加人工确认或暂缓相关能力?
这些问题不会替代评测。它们决定评测结果怎样进入产品决策。
对产品经理来说,一个可执行的改动是:在每张版本评测表后增加“适用范围”和“未覆盖风险”两栏。先让参与评审的人知道这个分数能说明什么,再决定是否扩大上线范围。