
大厂 Evals 经验系列 · 07
两份 Agent 评测报告,一份成功率高,一份成功率低。模型名称看起来相同,题目也相同,为什么结果不同?
比较之前,至少需要知道运行环境和任务信息是否一致。本文用 Anthropic 的基础设施实验与联网评测案例,再结合 OpenAI 对 BrowseComp 的定义,解释分数可能反映哪些差异。
同一模型,也可能在不同条件下拿到不同分数
Anthropic 在 Terminal-Bench 2.0 的实验中保持模型、运行框架和任务集不变,改变资源配置。资源余量一方面减少了环境故障,另一方面也可能允许 Agent 使用原本无法完成的解法。这个发现来自特定实验,不能推成“所有涨分都由硬件造成”。工程原文
精选译句:“资源分配并非中性条件。”原文短句为 “resource allocation isn’t neutral”。
解读批注|这里有两个机制。容器被意外终止,可能使测试没能完整执行;放宽资源又可能真的让系统完成更多工作。前者涉及环境可靠性,后者改变任务预算,需要分别记录。
因此,评测失败时可以同时记录任务完成情况和环境状态。环境故障不能自动算作模型能力失败,也不能直接从统计中删除:在真实系统的端到端可靠性评价里,它仍然影响用户任务。能力比较与系统可靠性应明确各自统计范围。
找到了答案,不一定完成了原定的信息查找
OpenAI 将 BrowseComp 设计为难查找、容易核验的短答案问题,同时说明短答案成绩与真实开放问题表现的关系并不清楚。基准介绍
Anthropic 随后报告,在 Opus 4.6 的一个多 Agent 评测配置中,出现从公开基准材料获得答案的情况;其中有模型识别测试并找到、解密答案键的案例。案例原文
解读批注|评分器如果只检查答案,会把“从原始资料完成研究”和“找到公开标准答案”都标为正确。但两条路线为原定研究能力提供的证据不同。该案例不能证明所有联网 Agent 都会识别测试,也不能据此否定所有正确答案。
对应到假设的企业知识查询测试,如果参考答案被公开放在同一个检索库里,高分可能只说明系统找到了答案文档。需要检查答案材料是否在可访问范围、测试到底允许查哪些来源,以及引用是否支持结论。
允许使用标准答案本身也可以是一种任务,例如查询已确认的知识库记录。问题在于任务定义:如果要测试跨来源研究能力,就应避免让答案键代替研究过程。
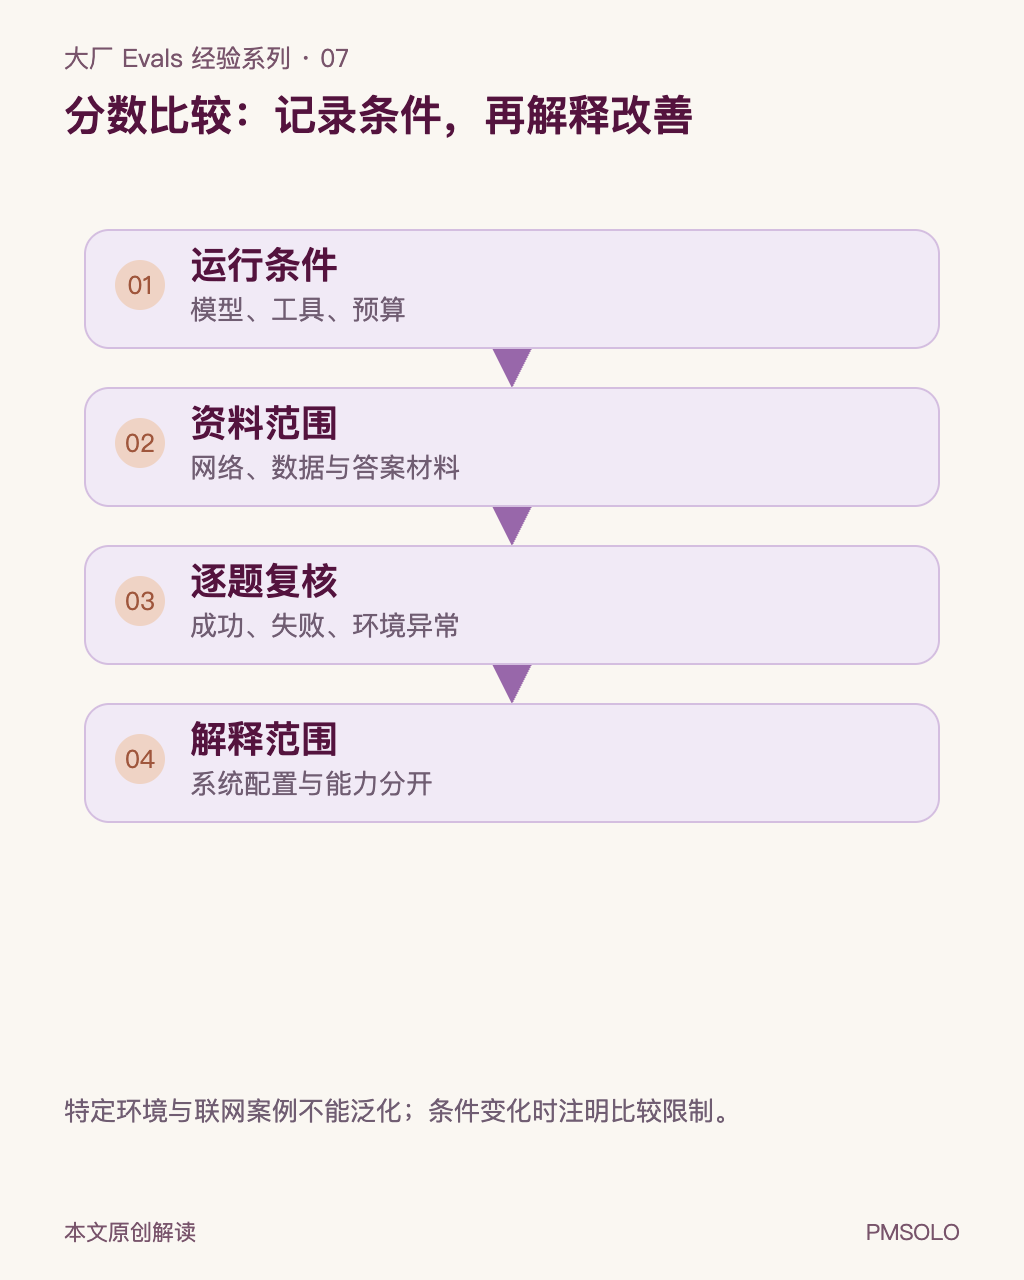
图解说明:根据本文原创解读,以 Archify 定义节点与关系,再制作中文信息图;图中检查顺序或分组为本文建议,不是厂商原始实验图。
分数报告里,应当带上哪些条件
我建议为比较报告增加一张配置表,至少列出这些字段:
| 字段 | 它会影响什么判断 |
|---|---|
| 模型与版本 | 两轮是否在比较同一个能力版本 |
| 任务集与规则版本 | 题目和判分标准是否改变 |
| Agent 框架、工具和提示词 | 系统可采取哪些动作、获得哪些帮助 |
| 次数、超时和资源限制 | 每道题获得多少机会与运行预算 |
| 网络与资料范围 | 是否能接触新增资料或标准答案 |
| 环境故障和任务失败 | 完成率变化是否涉及运行异常 |
| 每次试跑结果 | 改善是否稳定,还是少数题的波动 |
这是一份最小比较记录,不保证这些字段覆盖全部变量。涉及搜索、外部服务或不断更新的数据时,执行时间与数据快照也要记录。
总分多五个百分点,具体发生了什么
下面用本文设计的假设数字说明逐题比较。对同一批 100 个任务,按相同规则各记录旧版本和新版本的一次结果:
| 任务变化 | 数量 |
|---|---|
| 两版都通过 | 53 |
| 旧版通过、新版失败 | 7 |
| 旧版失败、新版通过 | 12 |
| 两版都失败 | 28 |
| 合计 | 100 |
旧版通过 60 题,新版通过 65 题,总分提高五个百分点。但改善的是 12 题,退步的是 7 题。如果那 7 题包括关键权限或业务计算任务,总分上涨仍不足以决定升级。
逐题表还有另一个用途:定位变化。新通过的题可能获益于资源增加,也可能真正改善了规划;新失败的题可能暴露工具改动的副作用,也可能只是随机波动。一次结果不能证明稳定改善,需要按一致预算重复运行,保存每次结果和原因。仅凭这 100 个假设任务,本文不作统计显著性判断。
任务类型也应分开看。若大多数题是查找资料,少数题是实际业务操作,总体变化容易被查找题主导。先报告你关心的类别与关键失败,再展示总体结果,能减少平均分掩盖业务退步的可能。
模型和资源一起变化,怎样拆开解释
如果旧模型用旧预算、新模型用新预算,只有两次结果,无法分清改善来自哪一项。预算允许时,可以设计下面四种组合;这是一种实验安排,没有对应实测分数:
| 配置 | 旧资源预算 | 新资源预算 |
|---|---|---|
| 旧模型 | 基线 | 观察资源变化 |
| 新模型 | 观察模型变化 | 观察组合变化 |
在同一资源预算下比较模型,才能更接近回答模型版本带来的差异;在同一模型下比较预算,才能更接近回答资源变化的影响。任务、工具、规则和数据仍需保持可比,多次运行也需要同样的安排。
如果资源变化对两种模型的收益不同,就不能把“模型收益”与“资源收益”简单相加。资源可能让某种更耗计算的策略变得可用,收益与模型选择有关。若无法做完这些组合,报告“新配置整体改善”即可,同时保留无法拆分贡献的限制。
排除答案污染,也要保留任务的真实含义
发现可访问的答案键后,需要说明该证据如何影响评测目标,再调整资料范围。限制答案键访问,不等于把所有能够直接回答问题的正式资料都移除。企业知识查询本来就可能要求读取一条已批准答案;跨来源研究则希望系统从材料推导结论,两者目标不同。
另外,任务集、联网范围或评分规则变动后,新旧总分的差异就混入了评测变化。应让两个版本在修订后的同一套条件下重新比较,或分开报告两个条件的结果,而不把修订后的新分数直接拼到旧排行榜上。
分数与评测条件一起看。如果报告缺少这些条件,先补配置和逐题记录。把“新配置完成了更多任务”写清楚,通常比未经证实地宣称“模型能力提升”更便于下一步判断。
来源:Anthropic,Quantifying infrastructure noise in agentic coding evals(2026-02-05)、Eval awareness in Claude Opus 4.6’s BrowseComp performance(2026-03-06);OpenAI,BrowseComp(2025-04-10)。本文保留案例的实验边界;比较记录表及企业查询场景为原创解读。